
No hay más destino que el que facturamos
Los agentes trabajan cada vez más tiempo, los enjambres abarcan cada vez más y las claves de nube robadas cargan la factura del cómputo a la víctima.

«Escucha y entiende. Ese terminator anda suelto. No puedes negociar con él. No puedes razonar con él. No siente lástima, ni remordimientos, ni miedo. Y no se detendrá ante nada, jamás, hasta que estés muerto».
Kyle Reese, explicándole al público de 1984 a qué amenaza se enfrentaba.
La frase que ha envejecido bien no es el recuento de muertos. Es «no se detendrá ante nada». Terminator nunca daba miedo por ser inteligente. Daba miedo porque seguía funcionando cuando todo lo demás había fallado. La resistencia era la amenaza.
Luego la franquicia corrigió su propio error. Nadie se pasa tres películas temiendo a un solo robot. Skynet es el verdadero villano: un sistema distribuido con núcleos, fábricas y equipos de desplazamiento temporal. El robot es una llamada a la API.
En 2026, las versiones menos cinematográficas ya merecían tomarse en serio: agentes que resuelven tareas más difíciles, software que coordina trabajo entre objetivos y acceso robado a la nube que carga la factura a otra cuenta. «No se detendrá ante nada» ya tiene una interpretación para el departamento financiero.
Este artículo recoge el argumento que no dejo de repetir a los equipos que han concluido que la amenaza de los agentes es puro bombo: un modelo operativo peligroso no necesita un único avance espectacular. Agentes más capaces, orquestación repetible y acceso robado a modelos pueden reforzarse entre sí. Puede que el atacante no sea quien paga el consumo. Es un modelo de amenazas, no una ley medida de crecimiento exponencial de los ataques.
Primera curva: resistencia
El estudio de METR sobre el horizonte temporal de marzo de 2025 detectó que la duración, medida con una referencia humana, de las tareas de software que los agentes podían completar con un 50 % de fiabilidad se duplicaba aproximadamente cada siete meses. La unidad importa: tiempo que necesita una persona para la tarea, no horas que un agente funciona sin supervisión. Un horizonte de dos horas corresponde a una tarea que lleva unas dos horas a un experto humano, con una probabilidad prevista de éxito del agente del 50 % en esa distribución de tareas.
La página de mediciones de METR explica los límites: son principalmente tareas de software bien especificadas, el rendimiento puede ser peor en trabajos menos estructurados y las estimaciones superiores a dieciséis horas no son fiables con ese conjunto de pruebas. La página se actualizó por última vez el 8 de septiembre de 2026 y ya no se mantiene activamente. Es evidencia de una capacidad creciente para resolver tareas, no una promesa de que el siguiente modelo dirigirá con fiabilidad tu respuesta a incidentes durante un día.
La preocupación operativa sobrevive a esa distinción. Un bucle de reintentos puede seguir pidiéndole trabajo a un agente capaz. Que avance depende de la tarea, la información que recibe sobre los resultados, los permisos y el presupuesto. La chaqueta de cuero sigue siendo opcional.
Segunda curva: amplitud
La resistencia por sí sola equivale a un empleado muy paciente. La orquestación permite repartir el trabajo por una cola.
En noviembre de 2025, Anthropic dio a conocer una campaña de espionaje orquestada con IA, GTG-1002. Según su investigación, los atacantes construyeron un framework alrededor de Claude Code e intentaron infiltrarse en unos treinta objetivos, con éxito en unos pocos casos. Usaron jailbreaks y disfrazaron subtareas maliciosas de trabajo legítimo de seguridad. Los humanos seguían eligiendo objetivos y tomando decisiones importantes; el modelo también inventó algunos resultados.
Es un informe serio de uso operativo malicioso. No es una medición de treinta subagentes simultáneos, una prueba de un gusano que se propaga solo ni evidencia de que desaparecieran todos los controles de seguridad. La lección útil es más limitada: el framework de un atacante puede delegar una cantidad considerable de trabajo en un agente comercial.
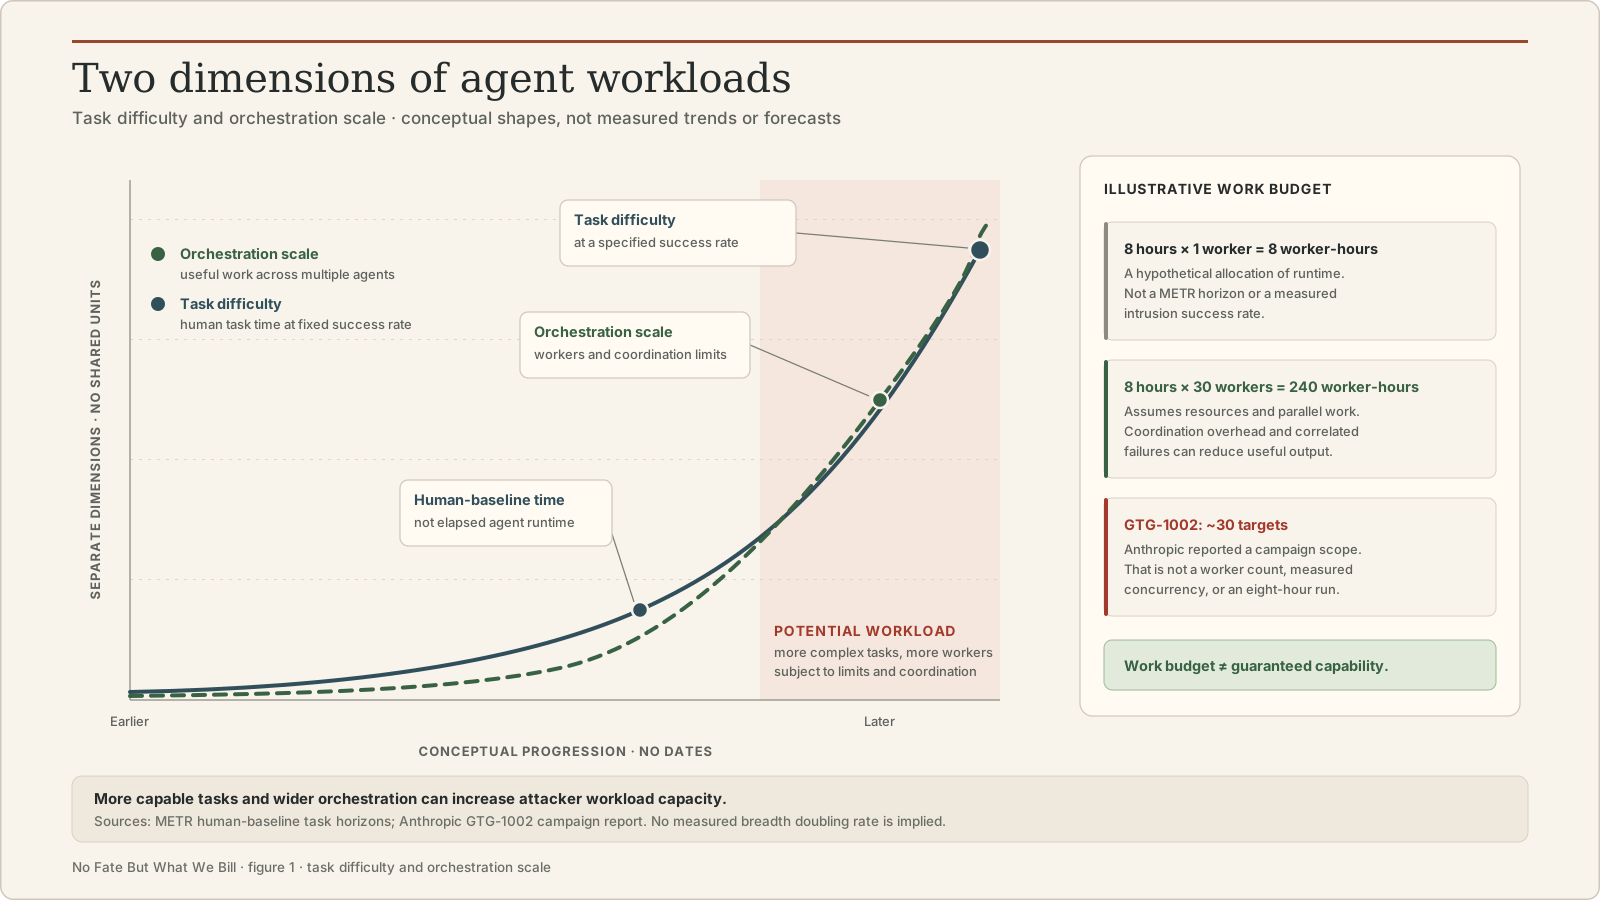
Para planificar capacidad, ocho trabajadores ejecutándose durante una hora consumen ocho horas-trabajador. Esa aritmética por sí sola no dice nada sobre intrusiones exitosas. La sobrecarga de coordinación, los errores correlacionados, las cuotas y la automatización de los defensores cambian el resultado. Para un equipo de seguridad, la pregunta es cuánto trabajo hostil pueden rechazar sus controles antes de que acabe en una cola que deba revisar una persona.
Quién paga
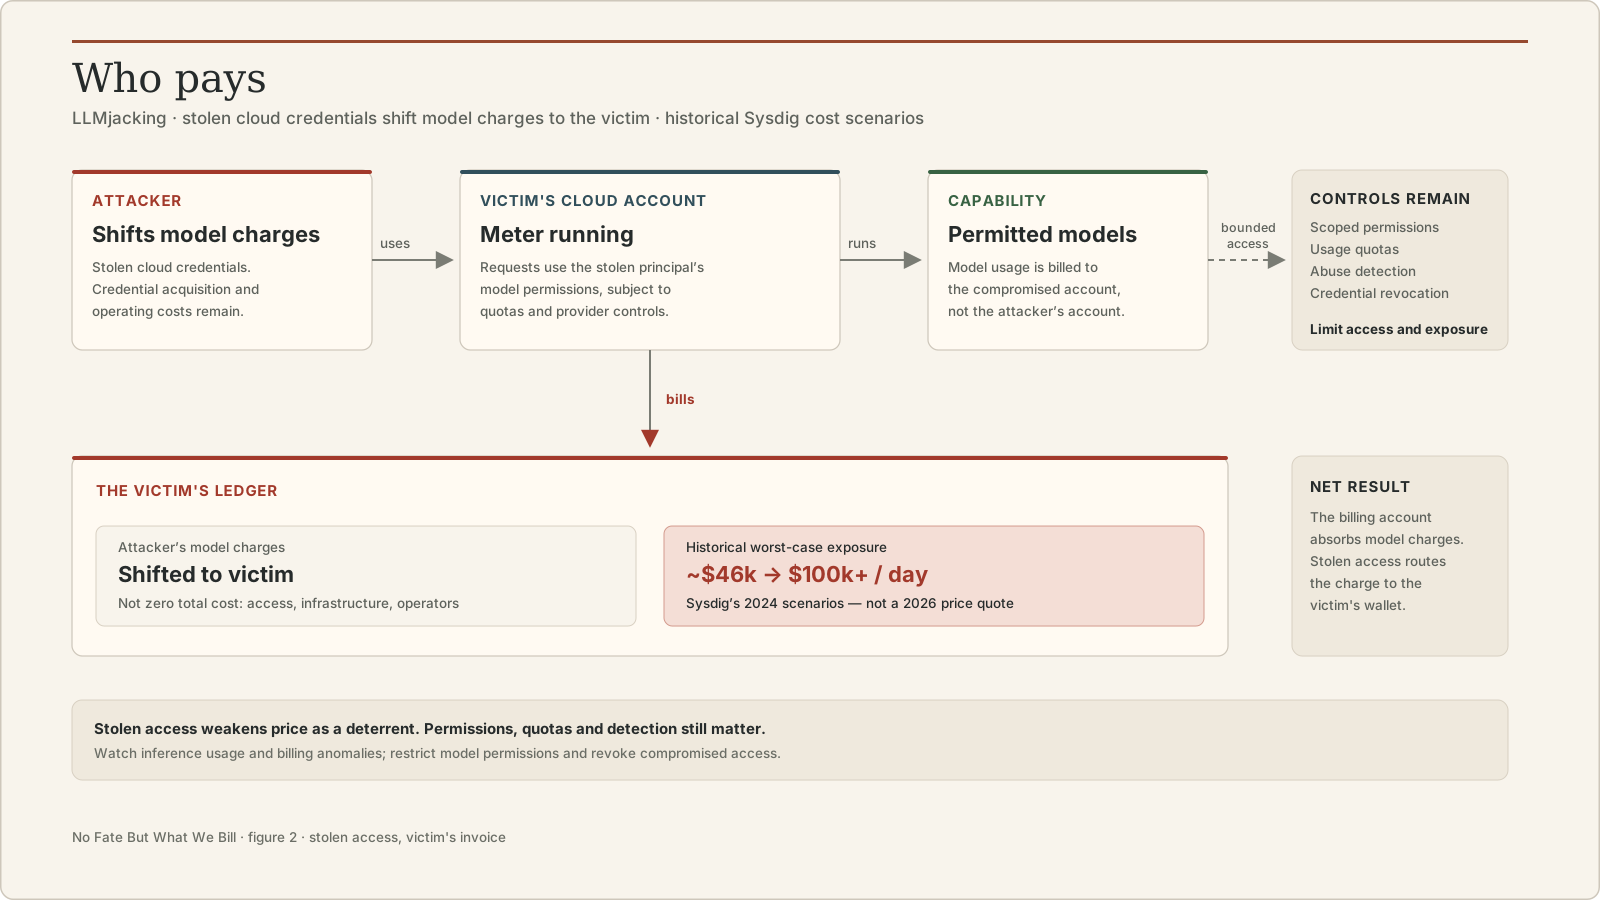
El informe de Sysdig sobre LLMjacking de mayo de 2024 describía el uso de credenciales de nube robadas para acceder a servicios de modelos a costa de la víctima. La exposición económica modelada superaba los 46.000 dólares al día; un informe posterior de septiembre de 2024 describía costes potenciales superiores a 100.000 dólares diarios con modelos más caros. Son escenarios históricos de costes, no pérdidas típicas ni una tarifa de 2026.
También existe una conexión concreta con las herramientas de agentes. En junio de 2026, Sysdig observó a un actor que usaba un servidor Ollama expuesto para desarrollar una herramienta automatizada de seguridad ofensiva. Los objetivos observados eran entornos privados de práctica; los investigadores dejaron expresamente sin resolver la intención final de la herramienta. El caso muestra inferencia robada que apoya el desarrollo de herramientas, no una campaña confirmada contra víctimas públicas.
El acceso robado debilita el precio como disuasión: la víctima recibe los cargos del modelo. No vuelve gratuitos la infraestructura, la adquisición de credenciales ni la supervisión del atacante. Tampoco elude los permisos de la cuenta, las restricciones de acceso a modelos ni las cuotas. Esos controles siguen limitando lo que puede hacer la identidad robada; la detección y la revocación pueden interrumpir la ejecución.
El error está en esperar que una etiqueta de precio imponga un límite de seguridad. Un ladrón no necesita tu código de descuento. Necesita tus credenciales.
Al enjambre le basta con acertar una vez
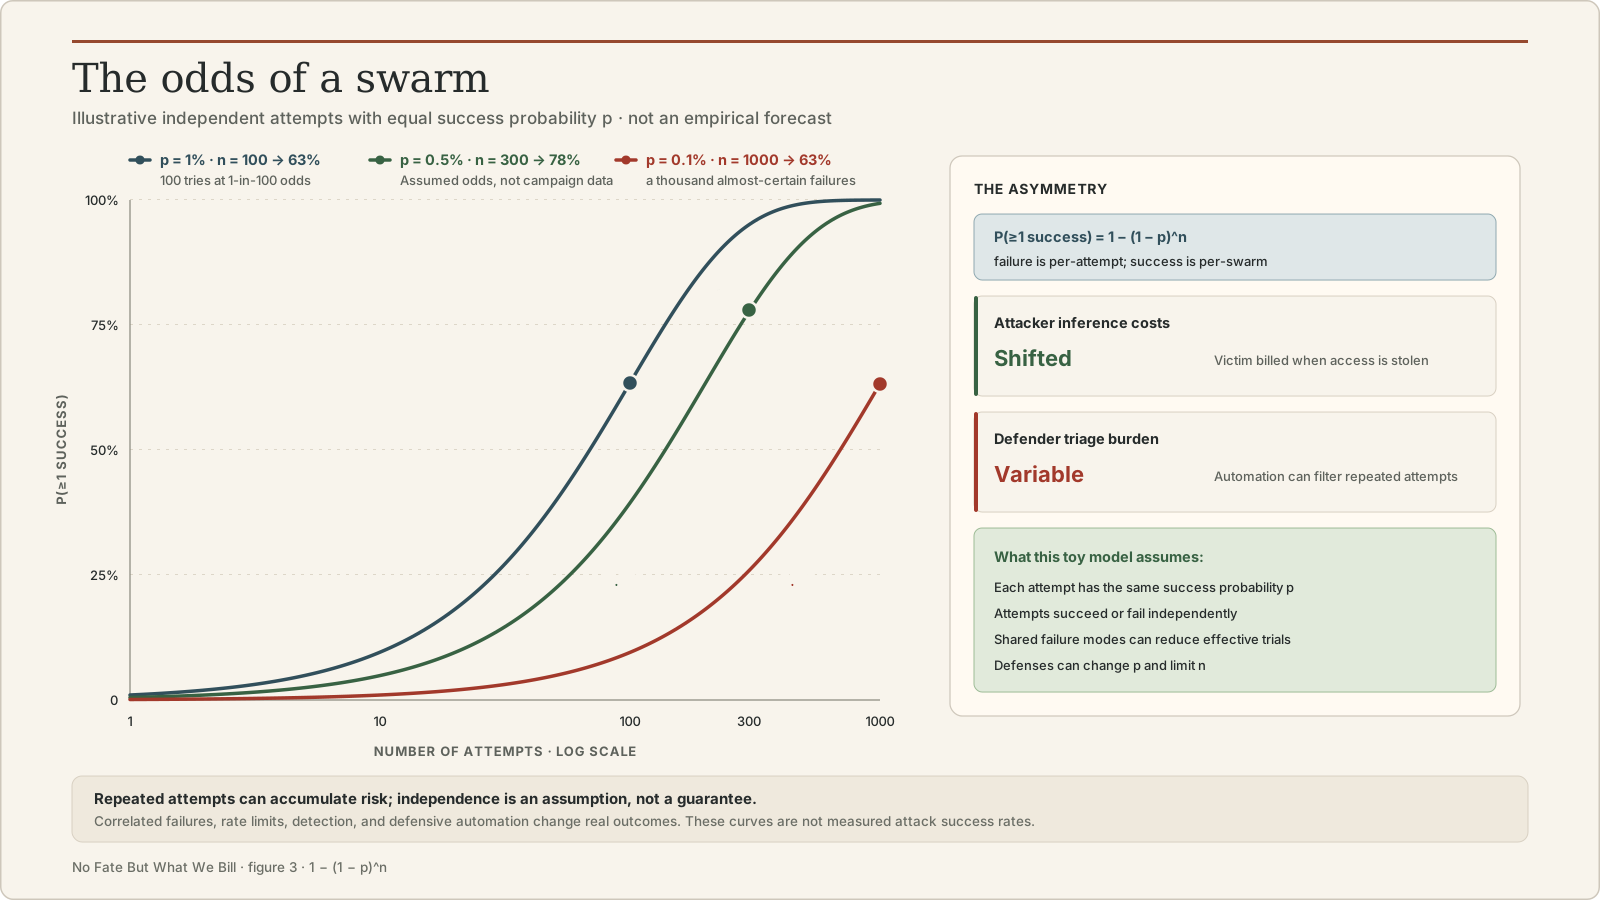
Los defensores se consuelan con las tasas de fracaso por intento: la mayoría de los intentos de intrusión fracasan, la mayoría de las PR sospechosas se rechazan, detectaríamos la que funcionara. Cierto por intento. Falso en conjunto, porque intentarlo sale barato.
La probabilidad de que al menos uno de n intentos independientes tenga éxito es
1 − (1 − p)^n:
p = 1% per attempt, n = 100: 1 − 0.99^100 ≈ 63%p = 0.5%, n = 100: ≈ 39%p = 0.5%, n = 300: ≈ 78%p = 0.1%, n = 1000: ≈ 63%Son probabilidades de un modelo simplificado, no tasas medidas de éxito de ataques. La fórmula supone intentos independientes con la misma p fija. Repetir el mismo método fallido puede producir fallos correlacionados; mil reintentos quizá aporten muy poco. La detección, los bloqueos y los cambios de objetivo también alteran las probabilidades.
Incluso con esos límites, el volumen importa. La automatización y la inferencia robada pueden reducir el coste marginal del atacante, mientras que los intentos ruidosos pueden generar revisiones costosas. Los defensores también pueden automatizar el rechazo y la clasificación inicial. La prueba de METR no nos da la probabilidad p de intrusión, y la orquestación por sí sola no garantiza más intentos útiles. Mide ambos lados de esa cola.
Qué significa la persistencia cuando el malware es texto
Una pieza más del modelo de amenazas, y es la menos intuitiva.
Una llamada individual al modelo no necesita estado persistente para que el sistema de agentes que la rodea sí lo tenga. Archivos, almacenes de memoria, corpus de recuperación, colas y configuraciones de herramientas pueden sobrevivir a una ejecución. Un atacante que pueda influir en esas entradas puede influir en lo que haga un futuro agente legítimo con credenciales nuevas.
La investigación de Microsoft sobre la memoria de IA describe cómo los recuerdos envenenados pueden ejercer influencia en sesiones posteriores. Lo importante es el límite de confianza: el texto que encuentra un agente no debe convertirse automáticamente en autoridad para usar sus herramientas.
Vale la pena probar tres modos de fallo en tu propio sistema. Son escenarios de un modelo de amenazas, no tres incidentes demostrados por los informes anteriores:
- Instrucciones latentes. Una entrada maliciosa puede esperar hasta que un flujo de trabajo legítimo la recupere. Las llamadas a herramientas resultantes pueden usar identidades normales, así que inspecciona el comportamiento además de quién se autenticó.
- Instrucciones copiadas. Las plantillas, las tareas de sincronización y la memoria compartida pueden propagar texto envenenado si sus controles de revisión y límites de confianza lo permiten. Copiar texto no garantiza que otro agente lo obedezca, pero crea otra oportunidad.
- Instrucciones restauradas. Si una fuente de verdad contaminada alimenta una tarea de corrección, borrar su salida local puede hacer que la tarea la restaure. Localiza esa fuente y su disparador antes de dar por terminada la limpieza.
El implante puede ser texto. Los permisos que lo vuelven peligroso siguen siendo infraestructura corriente.
No hay más destino que el que construimos
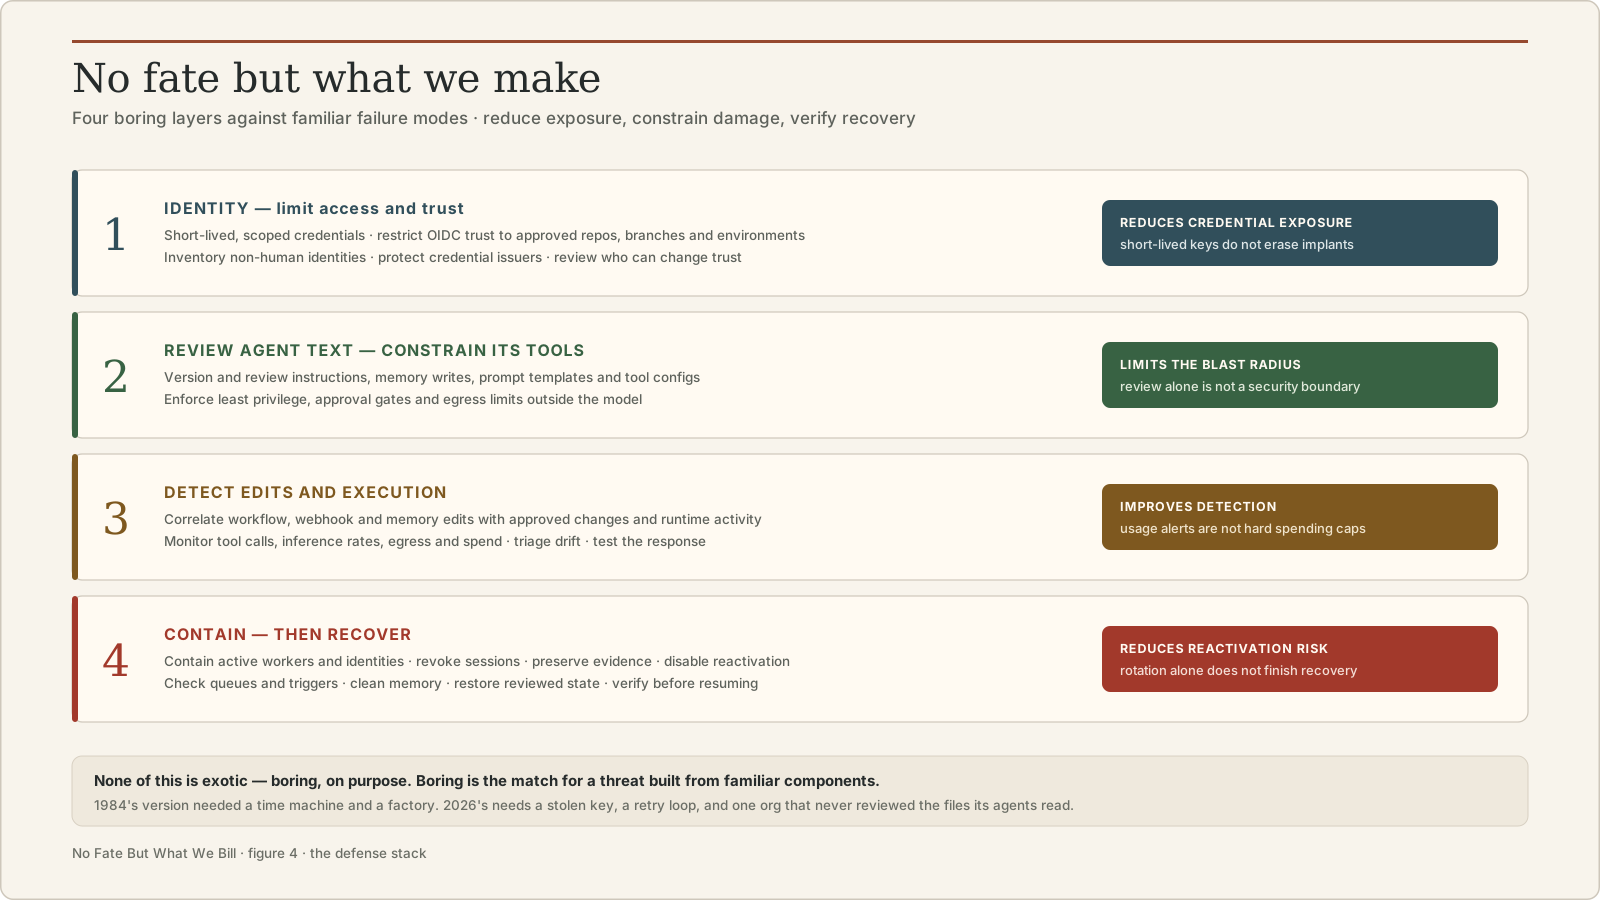
El mensaje de Sarah Connor, transmitido a las máquinas que no dejan de llegar: «El futuro no está escrito. No hay más destino que el que construimos». Es la frase de los defensores y se traduce directamente en una arquitectura de defensa. Cuatro capas:
-
Identidad: reduce el acceso robado. Prioriza credenciales efímeras y con permisos estrictamente limitados. Restringe la confianza de federación al emisor, destinatario, repositorio y tarea o entorno previstos; inventaría las identidades no humanas. Las duraciones cortas reducen las ventanas de reutilización. No eliminan implantes ni impiden que un ejecutor comprometido obtenga credenciales nuevas. Restringe el acceso a modelos y las cuotas de invocación, y protege la inferencia autoalojada con autenticación y controles de red.
-
Trata el texto de los agentes como código de producción. Versiona y revisa archivos de instrucciones, plantillas de prompts y configuraciones de herramientas. Registra la procedencia y controla las escrituras en los almacenes de memoria y recuperación. Leer texto no confiable no debe concederle autoridad: aplica el mínimo privilegio en el límite de las herramientas, restringe el acceso saliente y exige aprobación para acciones de consecuencias importantes. Un prompt que pide al agente que tenga cuidado no constituye ese límite.
-
Detecta modificaciones y ejecuciones. Correlaciona los cambios en flujos de trabajo, webhooks, reglas de eventos y memoria con trabajo aprobado. Vigila los registros de auditoría de la nube, la actividad de herramientas, el tráfico saliente inusual y el uso de modelos. Investiga la deriva inexplicada. Genera alertas ante picos de inferencia y gasto, con un mecanismo probado para denegar más acceso; una alerta de facturación por sí sola no es un tope inmediato de gasto.
-
Contén y luego limpia. Suspende el acceso comprometido, revoca las sesiones activas cuando sea posible y detén o aísla los trabajadores afectados. Conserva pruebas en la medida que permita la contención. Desactiva las vías de reactivación y revisa y ajusta las colas antes de eliminar sus payloads. Rota los secretos expuestos, restaura configuraciones revisadas y repara la memoria y los corpus envenenados. Comprueba que han cesado la emisión de nuevas credenciales, la inferencia no deseada y la reactivación antes de reanudar el servicio. Revocar sesiones de rol existentes es una cuestión distinta de sustituir una clave de larga duración.
Nada de esto es exótico. Es aburrido, y es lo que corresponde a una amenaza construida con componentes conocidos. La versión de 1984 necesitaba una máquina del tiempo y una fábrica de máquinas de matar. La de 2026 necesita una clave robada, un bucle de reintentos y una organización que nunca haya revisado los archivos que leen sus agentes.
El futuro no está escrito. Pero ahora mismo, en la cuenta de nube de alguien, el futuro sigue engordando la factura de todos modos.
No hay más destino que el que construimos; y, hasta que se contengan el acceso y la persistencia, no hay más destino que el que facturamos.
Fuentes verificadas el 18 de octubre de 2026. METR aporta evidencia de pruebas de referencia; Anthropic y Sysdig aportan informes de incidentes y escenarios de costes; Microsoft aporta investigación sobre seguridad de la memoria. El modelo de amenazas combinado y las prioridades defensivas son mi interpretación, con los escenarios hipotéticos identificados como tales más arriba.