
Pas de destin sauf ce que nous facturons
Les agents travaillent toujours plus longtemps, les essaims gagnent en envergure, et les clés cloud volées font payer le compute à la victime.

« Écoutez et comprenez. Ce Terminator est dehors. On ne peut pas négocier avec lui. On ne peut pas le raisonner. Il ne ressent ni pitié, ni remords, ni peur. Et il ne s’arrêtera absolument jamais, tant que vous ne serez pas mort. »
Kyle Reese, présentant au public de 1984 la nature de la menace.
Ce qui a bien vieilli dans cette réplique, ce n’est pas le nombre de victimes. C’est « ne s’arrêtera absolument jamais ». Le Terminator n’a jamais fait peur parce qu’il était intelligent. Il faisait peur parce qu’il continuait à fonctionner quand tout le reste avait échoué. La menace, c’était l’endurance.
Puis la franchise a corrigé sa propre erreur. Personne ne passe trois films à redouter un seul robot. Le véritable ennemi, c’est Skynet : un système distribué avec des cœurs, des usines et du matériel de déplacement temporel. Le robot est un appel d’API.
En 2026, les versions moins cinématographiques méritaient déjà d’être prises au sérieux : des agents traitant des tâches plus difficiles, des logiciels coordonnant le travail sur plusieurs cibles et des accès cloud volés faisant payer quelqu’un d’autre. « Ne s’arrêtera absolument jamais » a désormais son interprétation au service financier.
Cet article reprend l’argument que je ne cesse d’opposer aux équipes qui ont conclu que la menace agentique n’était que du battage : un modèle opérationnel dangereux n’a pas besoin d’une percée spectaculaire. Des agents plus capables, une orchestration reproductible et des accès volés aux modèles peuvent se renforcer mutuellement. L’attaquant n’est pas forcément celui qui paie la consommation. C’est un modèle de menace, pas une loi mesurée de croissance exponentielle des attaques.
Première courbe : l’endurance
L’étude de METR sur l’horizon temporel, publiée en mars 2025 a constaté un doublement environ tous les sept mois de la durée de référence humaine des tâches logicielles que les agents pouvaient accomplir avec une fiabilité de 50 %. L’unité compte : le temps nécessaire à un humain pour la tâche, pas le nombre d’heures pendant lesquelles un agent fonctionne sans surveillance. Un horizon de deux heures correspond à une tâche prenant environ deux heures à un expert humain, avec une réussite prédite de l’agent une fois sur deux sur cette distribution de tâches.
La page de mesures de METR précise les limites : il s’agit surtout de tâches logicielles bien définies, les performances peuvent être moins bonnes sur du travail moins structuré et les estimations au-delà de seize heures ne sont pas fiables avec cette batterie de tests. La page a été mise à jour pour la dernière fois le 8 septembre 2026 et n’est plus activement maintenue. Elle témoigne d’une capacité croissante à réaliser des tâches, sans promettre que le prochain modèle assurera de façon fiable votre réponse à incident pendant une journée.
La préoccupation opérationnelle résiste à cette distinction. Une boucle de nouvelles tentatives peut continuer à solliciter un agent capable. Ses progrès dépendent de la tâche, des retours sur ses résultats, des permissions et du budget. Le blouson en cuir reste facultatif.
Deuxième courbe : l’envergure
L’endurance seule, c’est un employé très patient. L’orchestration permet de répartir le travail dans une file de tâches.
En novembre 2025, Anthropic a révélé une campagne d’espionnage orchestrée par l’IA, GTG-1002. Selon son enquête, les attaquants ont construit un framework autour de Claude Code et tenté d’infiltrer une trentaine de cibles, avec succès dans un petit nombre de cas. Ils ont utilisé des jailbreaks et déguisé des sous-tâches malveillantes en travail de sécurité légitime. Les humains choisissaient toujours les cibles et prenaient les décisions importantes ; le modèle a aussi inventé certains résultats.
C’est un rapport sérieux d’utilisation malveillante en conditions opérationnelles. Ce n’est ni une mesure de trente sous-agents simultanés, ni la preuve d’un ver capable de se propager seul, ni la démonstration que tous les contrôles de sécurité avaient disparu. La leçon utile est plus précise : le framework d’un attaquant peut déléguer une quantité importante de travail à un agent commercial.
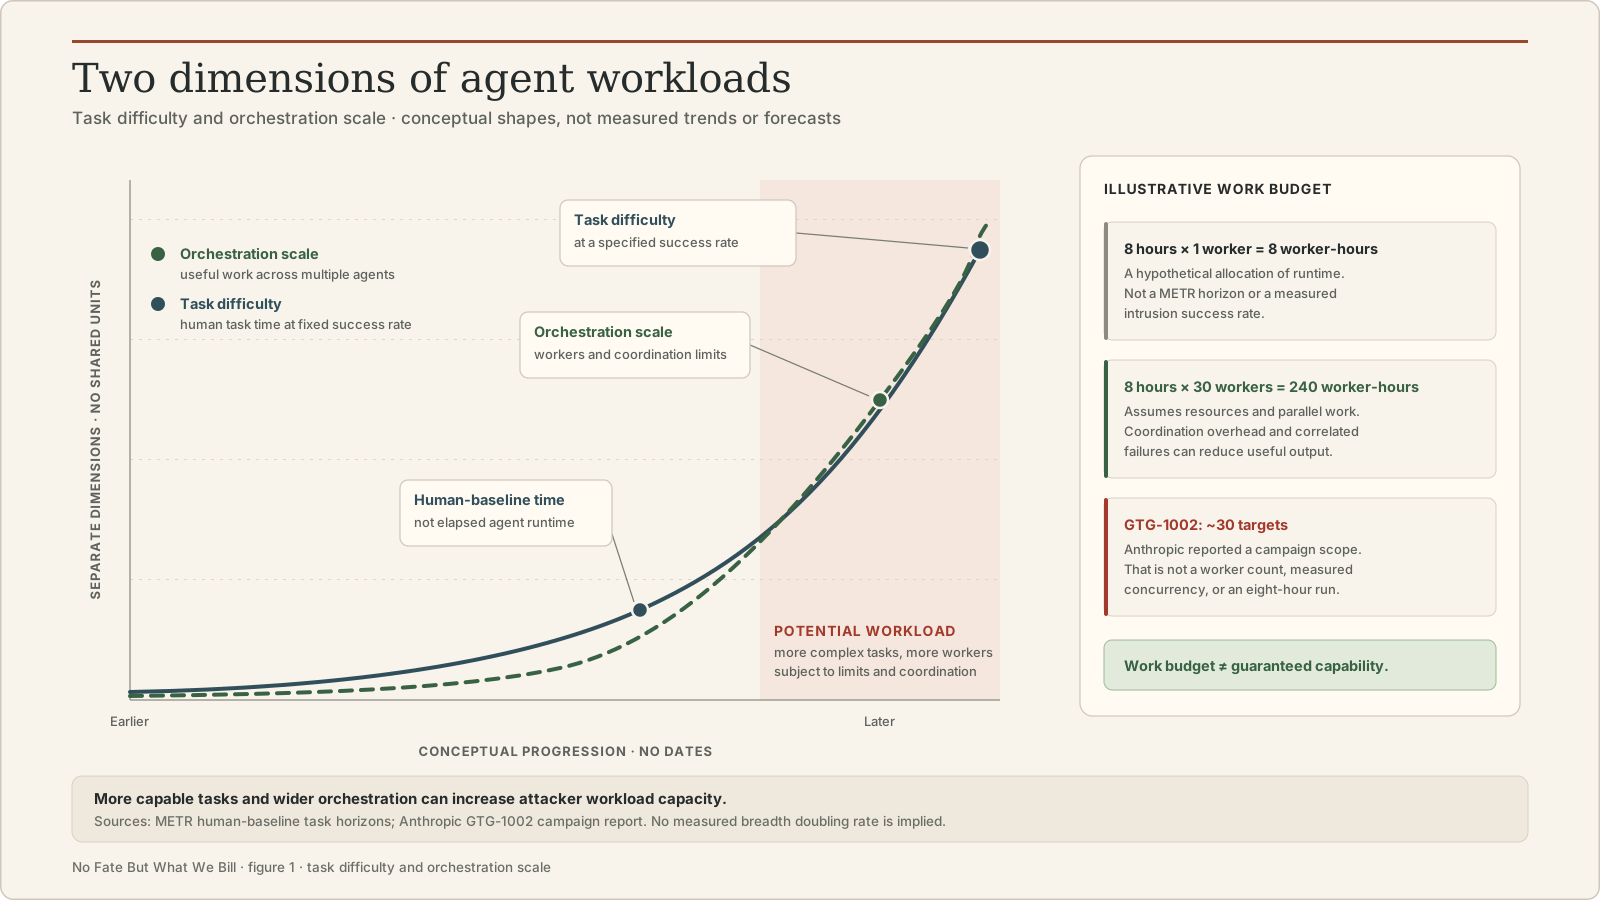
Pour planifier la capacité, huit exécutants fonctionnant pendant une heure consomment huit heures-exécutant. Ce calcul ne dit rien, à lui seul, sur les intrusions réussies. Les coûts de coordination, les erreurs corrélées, les quotas et l’automatisation des défenseurs changent tous le résultat. Pour une équipe de sécurité, la question est de savoir quelle quantité de travail hostile ses contrôles peuvent rejeter avant qu’elle n’atterrisse dans une file à examiner par un humain.
Qui paie
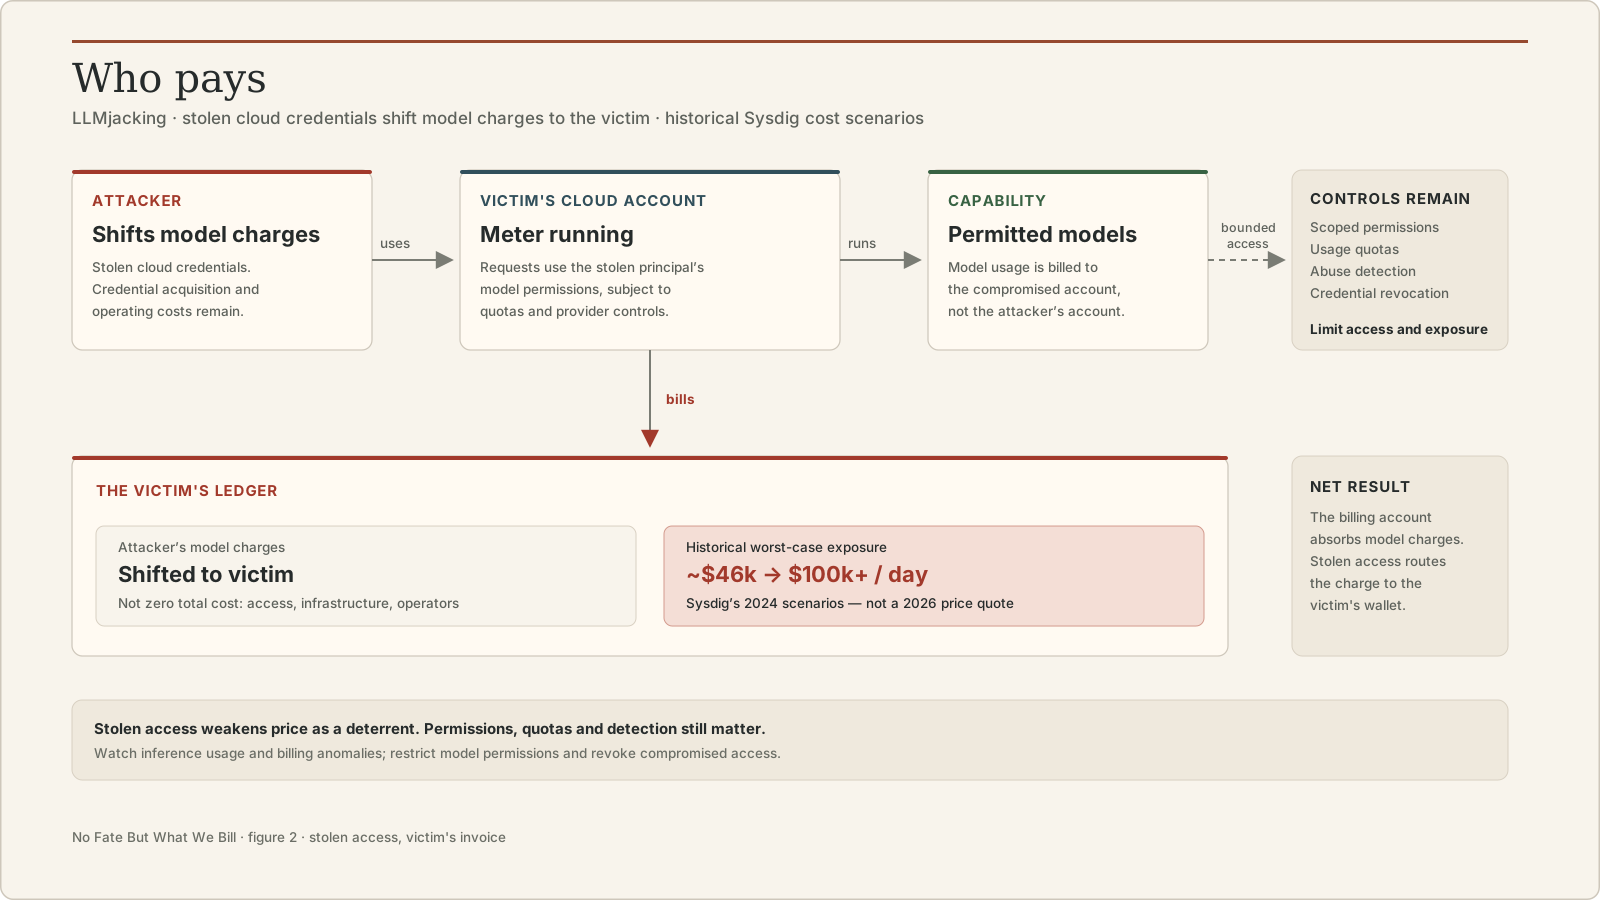
Le rapport de Sysdig sur le LLMjacking de mai 2024 décrivait l’utilisation d’identifiants cloud volés pour accéder à des services de modèles aux frais de la victime. L’exposition financière modélisée dépassait 46 000 dollars par jour ; un rapport de suivi de septembre 2024 décrivait des coûts potentiels supérieurs à 100 000 dollars par jour avec des modèles plus chers. Ce sont des scénarios de coûts historiques, pas des pertes typiques ni un tarif de 2026.
Il existe aussi un lien concret avec l’outillage des agents. En juin 2026, Sysdig a observé un acteur utilisant un serveur Ollama exposé pour développer un outil automatisé de sécurité offensive. Les cibles observées étaient des environnements privés d’entraînement ; les chercheurs ont explicitement laissé ouverte la question de l’intention finale de l’outil. Ce cas montre de l’inférence volée au service du développement d’outils, pas une campagne confirmée contre des victimes publiques.
L’accès volé affaiblit le prix comme moyen de dissuasion : la victime reçoit les frais du modèle. Il ne rend pas gratuits l’infrastructure de l’attaquant, l’acquisition des identifiants ou la supervision. Il ne contourne pas non plus les permissions du compte, les restrictions d’accès aux modèles ni les quotas. Ces contrôles continuent de limiter ce que peut faire l’identité volée ; la détection et la révocation peuvent interrompre l’exécution.
L’erreur, c’est d’attendre d’une étiquette de prix qu’elle fasse respecter une frontière de sécurité. Un voleur n’a pas besoin de votre code promo. Il lui faut vos identifiants.
L’essaim n’a besoin de réussir qu’une seule fois
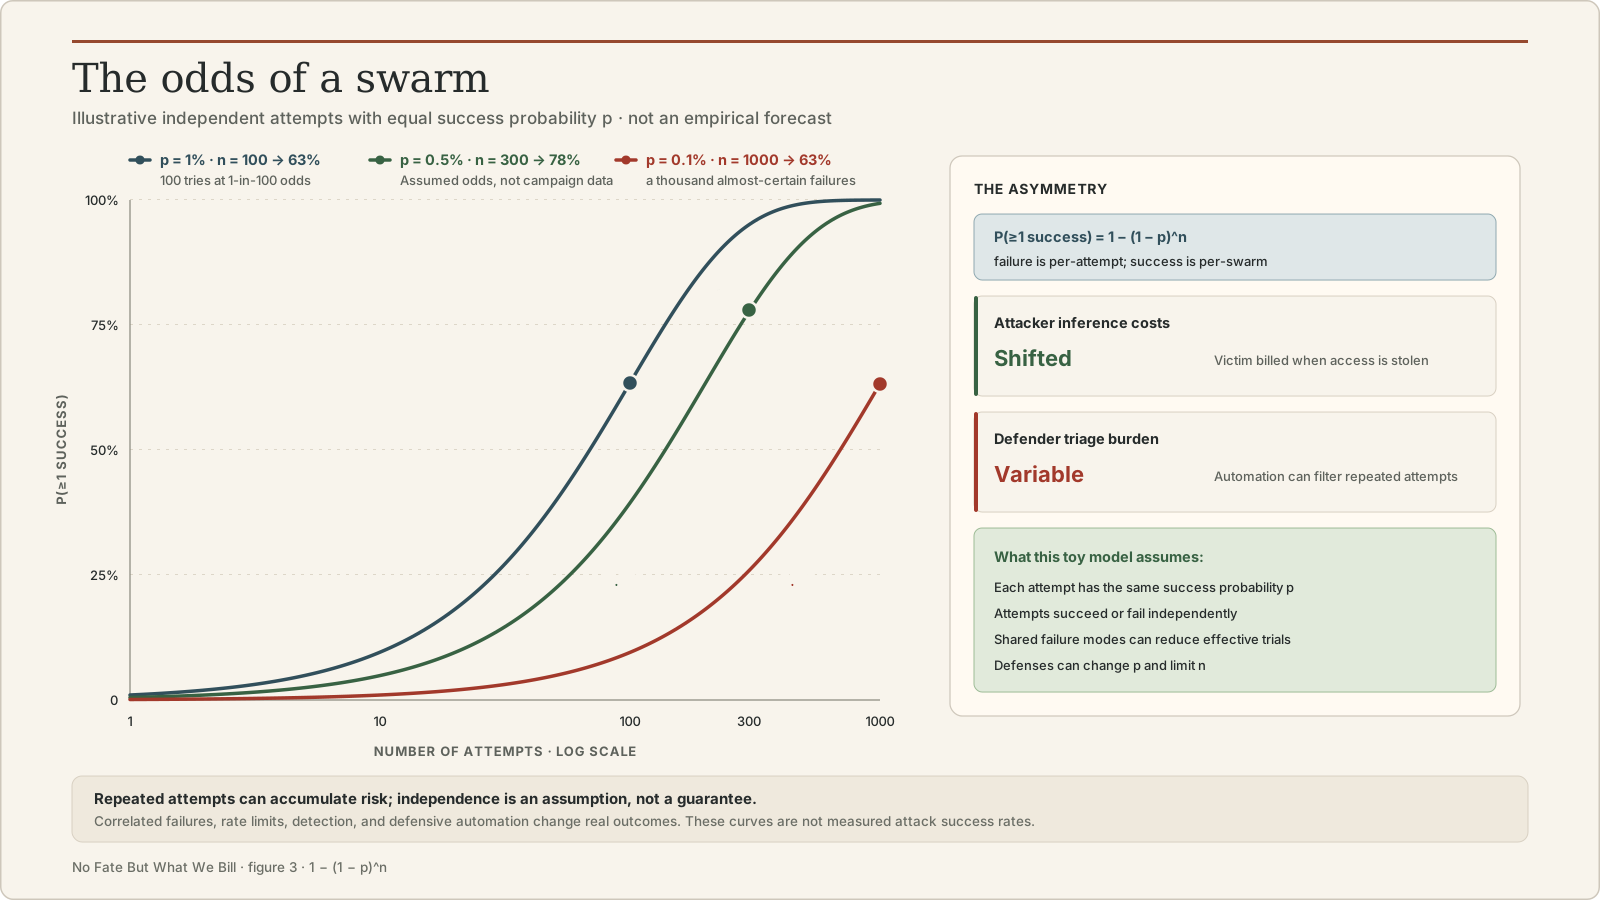
Les défenseurs se rassurent avec les taux d’échec par tentative : la plupart des tentatives d’intrusion échouent, la plupart des PR suspectes sont rejetées, on repérerait celle qui fonctionne. Vrai par tentative. Faux à l’échelle de l’ensemble, car les tentatives coûtent peu.
La probabilité qu’au moins une des n tentatives indépendantes réussisse est
1 − (1 − p)^n :
p = 1% per attempt, n = 100: 1 − 0.99^100 ≈ 63%p = 0.5%, n = 100: ≈ 39%p = 0.5%, n = 300: ≈ 78%p = 0.1%, n = 1000: ≈ 63%Ce sont les probabilités d’un modèle simplifié, pas des taux mesurés de réussite d’attaques. La formule suppose des tentatives indépendantes avec la même valeur fixe de p. Répéter la même approche défaillante peut produire des échecs corrélés ; mille nouvelles tentatives peuvent n’apporter presque rien. La détection, les blocages et les changements de cible modifient aussi les probabilités.
Même avec ces limites, le volume compte. L’automatisation et l’inférence volée peuvent réduire le coût marginal de l’attaquant, tandis que des tentatives bruyantes peuvent engendrer un travail d’examen coûteux. Les défenseurs peuvent eux aussi automatiser le rejet et le triage. Le benchmark de METR ne nous donne pas la probabilité d’intrusion p, et l’orchestration seule ne garantit pas davantage de tentatives utiles. Mesurez les deux côtés de cette file.
Ce que signifie la persistance quand le malware est du texte
Encore une pièce du modèle de menace, et c’est la moins intuitive.
Un appel individuel au modèle n’a pas besoin d’état persistant pour que le système d’agents qui l’entoure en possède un. Les fichiers, les mémoires, les corpus de recherche documentaire, les files d’attente et les configurations d’outils peuvent survivre à une exécution. Un attaquant capable d’influencer ces entrées peut influencer ce qu’un futur agent légitime fera avec de nouveaux identifiants.
Les travaux de Microsoft sur la mémoire de l’IA décrivent comment des souvenirs empoisonnés peuvent exercer leur influence lors de sessions ultérieures. La frontière de confiance est le point important : le texte rencontré par un agent ne doit pas devenir automatiquement une autorisation d’utiliser ses outils.
Trois modes de défaillance méritent d’être testés dans votre propre système. Ce sont des scénarios de modélisation des menaces, pas trois incidents établis par les rapports ci-dessus :
- Instructions dormantes. Une entrée malveillante peut attendre qu’un workflow légitime la récupère. Les appels d’outils qui en résultent peuvent utiliser des identités normales : examinez donc le comportement, pas seulement qui s’est authentifié.
- Instructions copiées. Les modèles de documents, les tâches de synchronisation et la mémoire partagée peuvent diffuser du texte empoisonné si leurs mécanismes de revue et leurs frontières de confiance le permettent. Copier du texte ne garantit pas qu’un autre agent y obéira, mais crée une occasion supplémentaire.
- Instructions restaurées. Si une source de vérité contaminée alimente une tâche de remédiation, supprimer sa sortie locale peut amener la tâche à la restaurer. Trouvez cette source et son déclencheur avant de déclarer le nettoyage terminé.
L’implant peut être du texte. Les permissions qui le rendent dangereux restent de l’infrastructure ordinaire.
Pas de destin sauf ce que nous faisons
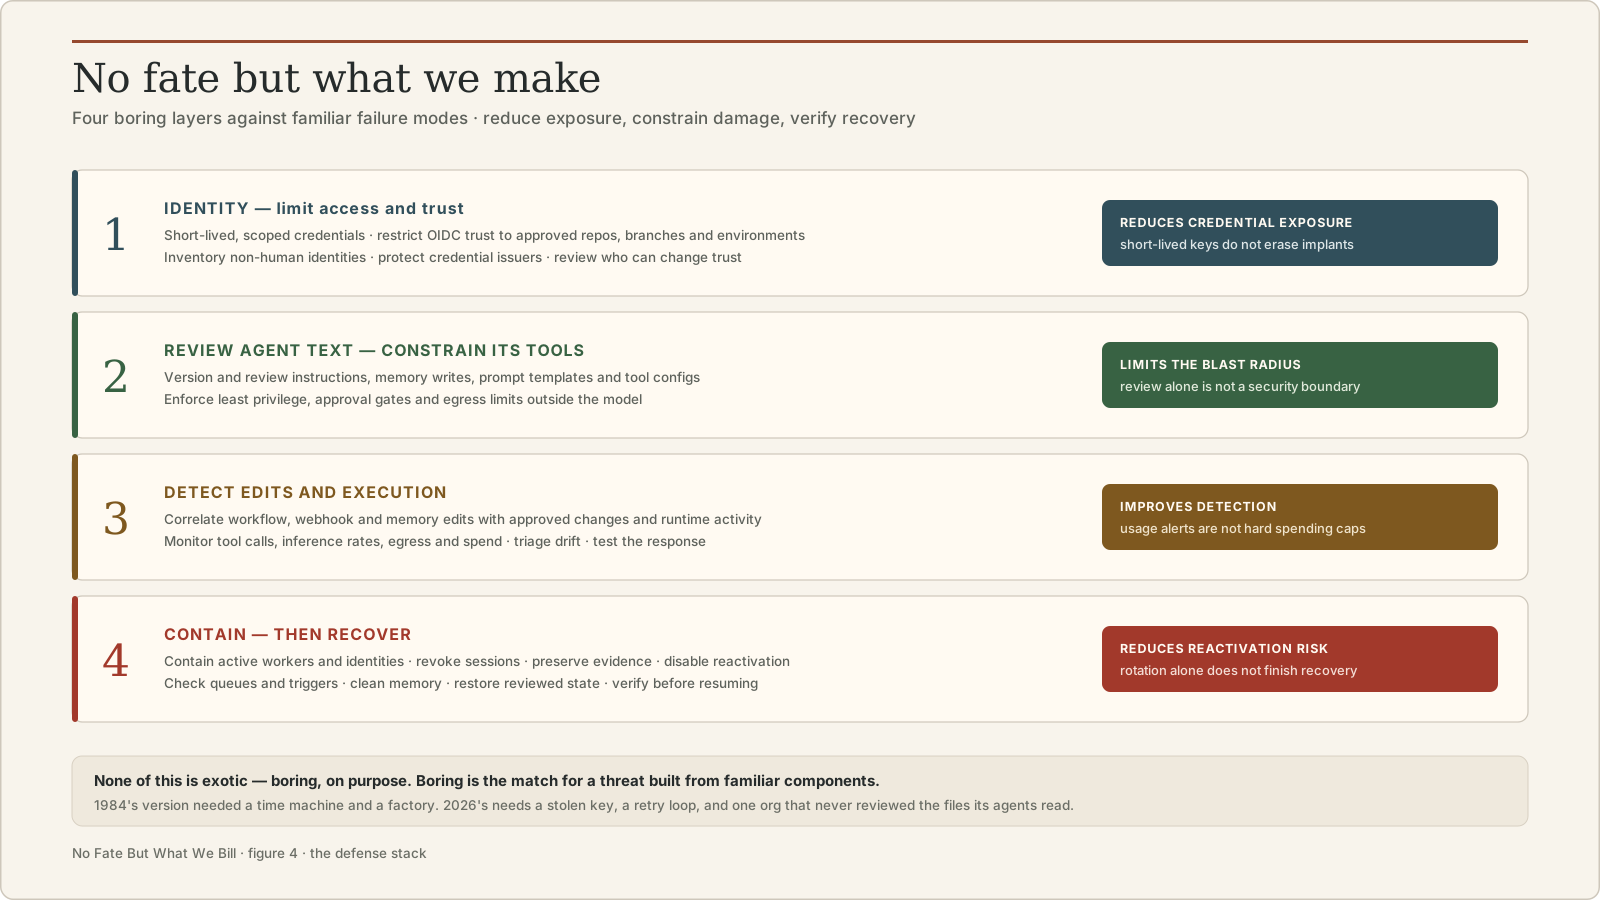
Le message de Sarah Connor, transmis aux machines qui continuent d’arriver : « L’avenir n’est pas fixé. Pas de destin sauf ce que nous faisons. » C’est la réplique des défenseurs, et elle se traduit directement en architecture de défense. Quatre couches :
-
Identité — réduisez la portée de l’accès volé. Privilégiez des identifiants de courte durée, aux permissions étroitement limitées. Restreignez la confiance de fédération à l’émetteur, à l’audience, au dépôt et à la tâche ou à l’environnement prévus ; inventoriez les identités non humaines. Les durées courtes réduisent les fenêtres de réutilisation. Elles n’éliminent pas les implants et n’empêchent pas un runner compromis d’obtenir de nouveaux identifiants. Restreignez l’accès aux modèles et les quotas d’invocation, et protégez l’inférence auto-hébergée par l’authentification et des contrôles réseau.
-
Traitez le texte des agents comme du code de production. Versionnez et révisez les fichiers d’instructions, les modèles de prompts et les configurations d’outils. Enregistrez la provenance et contrôlez les écritures en mémoire et dans les bases documentaires. Lire du texte non fiable ne doit pas lui conférer d’autorité : imposez le moindre privilège à la frontière des outils, limitez les accès sortants et exigez une approbation pour les actions à fortes conséquences. Un prompt demandant à l’agent d’être prudent ne constitue pas cette frontière.
-
Détectez les modifications et l’exécution. Mettez en relation les changements de workflows, de webhooks, de règles d’événements et de mémoire avec le travail approuvé. Surveillez les journaux d’audit cloud, l’activité des outils, le trafic sortant inhabituel et l’utilisation des modèles. Examinez les écarts inexpliqués. Déclenchez des alertes sur les pics d’inférence et de dépenses, avec un moyen testé de refuser tout accès supplémentaire ; une alerte de facturation seule n’est pas un plafond de dépenses immédiat.
-
Confinez, puis nettoyez. Suspendez les accès compromis, révoquez les sessions actives lorsque c’est possible et arrêtez ou isolez les exécutants touchés. Préservez les preuves dans la mesure où le confinement le permet. Désactivez les voies de réactivation et vérifiez puis corrigez l’état des files avant de supprimer leurs charges malveillantes. Renouvelez les secrets exposés, restaurez des configurations revues et réparez la mémoire et les corpus empoisonnés. Vérifiez que l’émission de nouveaux identifiants, l’inférence indésirable et la réactivation ont cessé avant de reprendre. Révoquer les sessions de rôle existantes est une question distincte du remplacement d’une clé de longue durée.
Rien de tout cela n’est exotique. C’est ennuyeux, et c’est ce qu’il faut face à une menace construite avec des composants familiers. La version de 1984 nécessitait une machine à remonter le temps et une usine de machines à tuer. Celle de 2026 nécessite une clé volée, une boucle de nouvelles tentatives et une organisation qui n’a jamais examiné les fichiers lus par ses agents.
L’avenir n’est pas fixé. Mais en ce moment, sur le compte cloud de quelqu’un, l’avenir fait grimper la note quoi qu’il arrive.
Pas de destin sauf ce que nous faisons — et, tant que l’accès et la persistance ne sont pas contenus, pas de destin sauf ce que nous facturons.
Sources vérifiées le 18 octobre 2026. METR fournit les résultats de benchmarks ; Anthropic et Sysdig fournissent les rapports d’incidents et les scénarios de coûts ; Microsoft fournit la recherche sur la sécurité de la mémoire. Le modèle de menace combiné et les priorités défensives sont mon interprétation, les scénarios hypothétiques étant signalés comme tels ci-dessus.