
Kein Schicksal außer dem, was wir abrechnen
Agents laufen immer länger, Schwärme fächern immer weiter auf und gestohlene Cloud-Keys wälzen die Compute-Rechnung auf das Opfer ab.

„Hör zu und begreife. Dieser Terminator ist da draußen. Man kann nicht mit ihm verhandeln. Man kann nicht mit ihm reden. Er fühlt weder Mitleid noch Reue noch Furcht. Und er wird nicht eher aufhören, niemals, bis du tot bist.“
Kyle Reese klärt 1984 sein Publikum über die Gestalt der Bedrohung auf.
Die Zeile, die gut gealtert ist, ist nicht der Bodycount. Es ist: „wird nicht eher aufhören.“ Der Terminator war nie deshalb gruselig, weil er klug war. Er war gruselig, weil er einfach weitergemacht hat, nachdem alles andere versagt hatte. Ausdauer war die Bedrohung.
Später hat das Franchise seinen eigenen Fehler korrigiert. Niemand fürchtet sich drei Filme lang vor einem einzelnen Roboter. Skynet ist der eigentliche Bösewicht: ein verteiltes System mit Rechenzentren, Fabriken und Zeitverschiebungsausrüstung. Der Roboter ist nur ein API-Aufruf.
Bis 2026 waren die weniger filmreifen Varianten ernst zu nehmen: Agenten bearbeiten schwierigere Aufgaben, Software koordiniert Arbeit über mehrere Ziele hinweg, und gestohlener Cloud-Zugriff landet auf der Rechnung eines anderen. „Wird nicht eher aufhören“ hat inzwischen auch eine Lesart für die Finanzabteilung.
Dieser Beitrag ist das Argument, das ich immer wieder Teams vorhalte, die die agentische Bedrohung für reinen Hype halten: Ein gefährliches Betriebsmodell braucht keinen spektakulären Einzeldurchbruch. Leistungsfähigere Agenten, wiederholbare Orchestrierung und gestohlener Modellzugriff können sich gegenseitig verstärken. Der Angreifer muss nicht derjenige sein, der den Zähler bezahlt. Das ist ein Bedrohungsmodell, kein gemessenes Gesetz exponentiellen Angriffswachstums.
Erste Kurve: Ausdauer
METRs Zeithorizont-Studie vom März 2025 stellte fest: Die anhand menschlicher Bearbeitungszeit gemessene Dauer von Softwareaufgaben, die Agenten mit 50 % Zuverlässigkeit lösen konnten, verdoppelte sich etwa alle sieben Monate. Die Einheit zählt: menschliche Bearbeitungszeit, nicht Stunden unbeaufsichtigter Agentenlaufzeit. Ein Zweistundenhorizont bedeutet eine Aufgabe, für die ein menschlicher Experte etwa zwei Stunden braucht und bei deren Aufgabenverteilung dem Agenten in der Hälfte der Fälle Erfolg vorhergesagt wird.
METRs Messseite erklärt die Grenzen: Es geht überwiegend um klar spezifizierte Softwareaufgaben; bei unübersichtlicherer Arbeit kann die Leistung schlechter sein. Schätzungen oberhalb von sechzehn Stunden sind mit dieser Testsuite unzuverlässig. Die Seite wurde zuletzt am 8. September 2026 aktualisiert und wird nicht mehr aktiv gepflegt. Sie belegt wachsende Aufgabenkompetenz, verspricht aber nicht, dass das nächste Modell zuverlässig einen Tag lang eure Incident Response übernimmt.
Die betriebliche Sorge bleibt trotz dieser Unterscheidung bestehen. Eine Retry-Schleife kann einen fähigen Agenten immer wieder zur Arbeit auffordern. Ob er vorankommt, hängt von Aufgabe, Feedback, Berechtigungen und Budget ab. Die Lederjacke bleibt optional.
Zweite Kurve: Breite
Ausdauer allein ist nur ein sehr geduldiger Mitarbeiter. Orchestrierung verteilt die Arbeit über eine Warteschlange.
Im November 2025 veröffentlichte Anthropic einen Bericht über die KI-orchestrierte Spionagekampagne GTG-1002. Laut dieser Untersuchung bauten Angreifer ein Framework um Claude Code und versuchten, in etwa dreißig Ziele einzudringen. In wenigen Fällen gelang es. Sie nutzten Jailbreaks und tarnten bösartige Teilaufgaben als legitime Sicherheitsarbeit. Menschen wählten weiterhin Ziele und trafen wichtige Entscheidungen; das Modell erfand außerdem einige Ergebnisse.
Das ist ein ernst zu nehmender Bericht über operativen Missbrauch. Er misst nicht dreißig gleichzeitige Sub-Agenten, belegt keinen selbstverbreitenden Wurm und zeigt auch nicht, dass sämtliche Schutzmaßnahmen verschwanden. Die nützliche Schlussfolgerung ist enger: Das Framework eines Angreifers kann erhebliche Arbeit an einen kommerziellen Agenten delegieren.
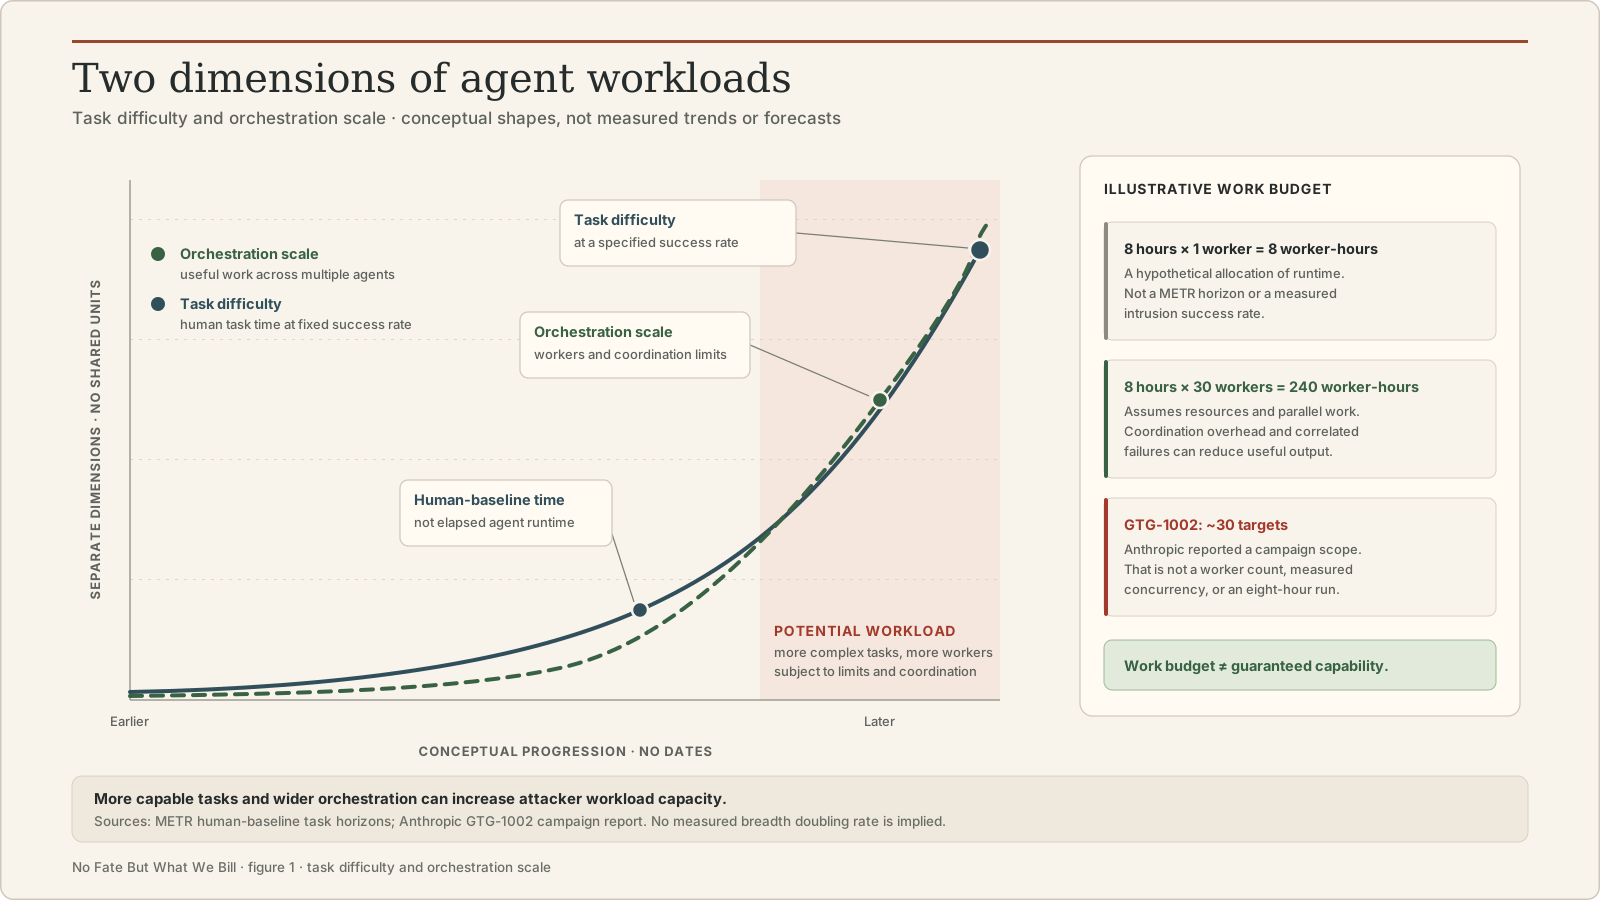
Für die Kapazitätsplanung verbrauchen acht Worker, die eine Stunde laufen, acht Worker-Stunden. Diese Rechnung allein sagt nichts über erfolgreiche Einbrüche aus. Koordinierungsaufwand, korrelierte Fehler, Quoten und Automatisierung auf Verteidigerseite verändern das Ergebnis. Für ein Sicherheitsteam stellt sich die Frage, wie viel feindliche Arbeit seine Kontrollen abweisen können, bevor sie in einer menschlichen Warteschlange landet.
Wer zahlt
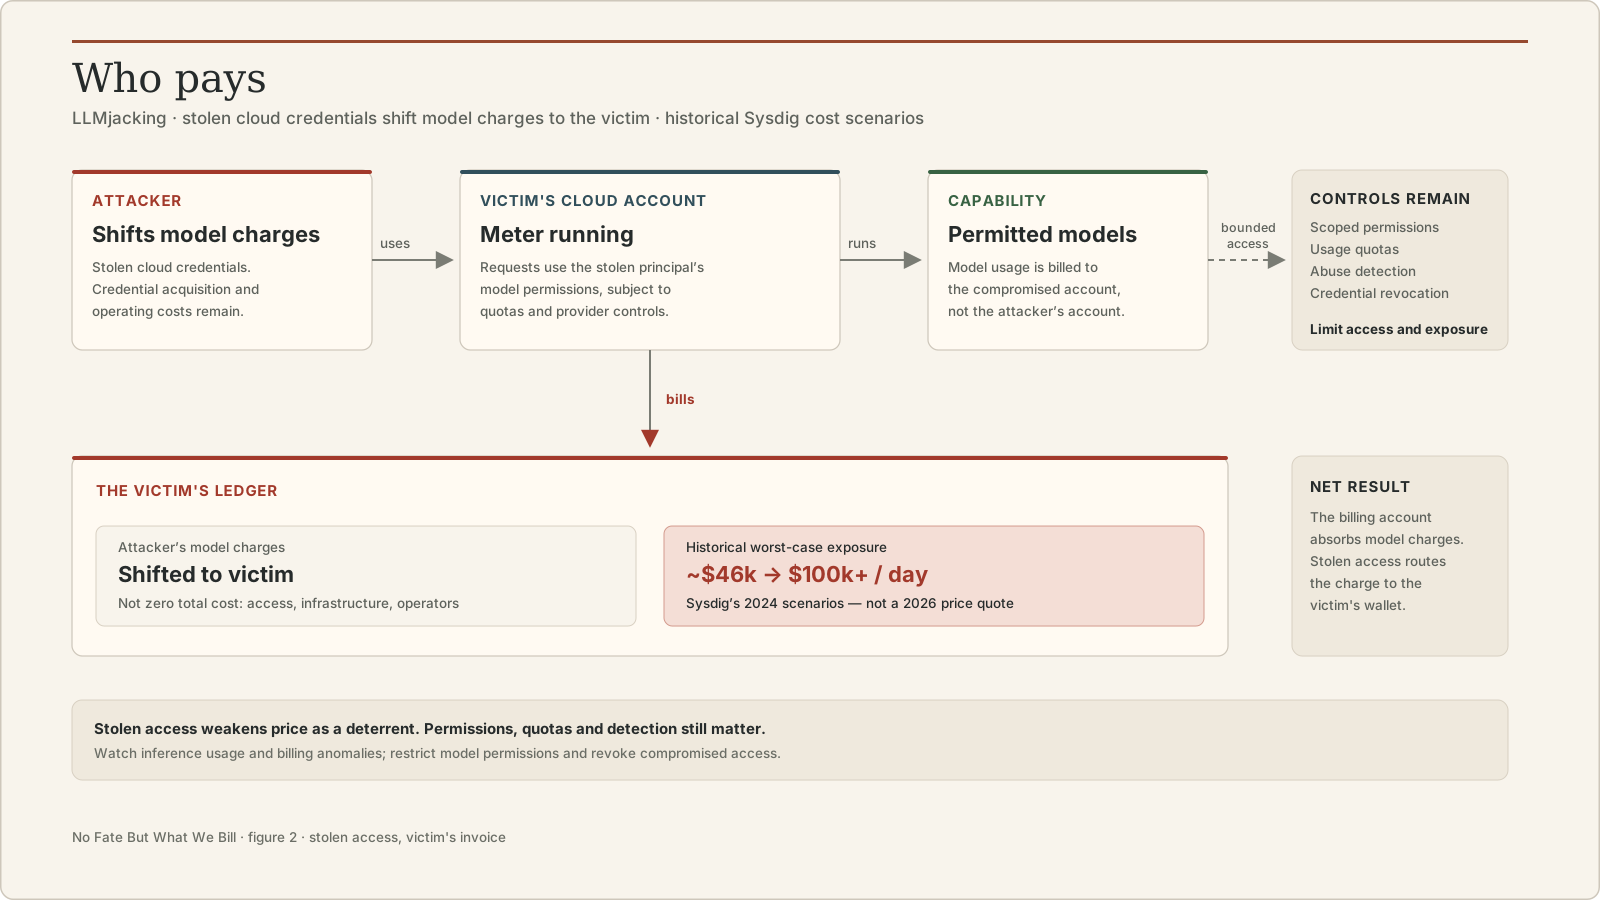
Sysdigs LLMjacking-Bericht vom Mai 2024 beschrieb den Zugriff auf Modelldienste mit gestohlenen Cloud-Zugangsdaten auf Kosten des Opfers. Das modellierte Kostenrisiko überstieg 46.000 US-Dollar pro Tag; ein Folgebericht vom September 2024 beschrieb mögliche Kosten von über 100.000 US-Dollar pro Tag mit teureren Modellen. Das sind historische Kostenszenarien, keine typischen Schäden und kein Preisangebot für 2026.
Es gibt auch eine konkrete Verbindung zu Agentenwerkzeugen. Im Juni 2026 beobachtete Sysdig, wie ein Akteur einen offen erreichbaren Ollama-Server zur Entwicklung eines automatisierten offensiven Sicherheitswerkzeugs nutzte. Die beobachteten Ziele waren private Übungsumgebungen; die Forscher ließen den späteren Verwendungszweck ausdrücklich offen. Der Fall zeigt gestohlene Inferenzleistung zur Werkzeugentwicklung, keine bestätigte Kampagne gegen öffentliche Opfer.
Gestohlener Zugriff schwächt den Preis als Abschreckung: Das Opfer bekommt die Modellrechnung. Infrastruktur, Beschaffung der Zugangsdaten und Beaufsichtigung des Angriffs werden dadurch nicht kostenlos. Ebenso wenig umgeht das die Berechtigungen des Kontos, Modellzugriffsbeschränkungen oder Quoten. Diese Kontrollen begrenzen weiterhin, was die gestohlene Identität tun kann; Erkennung und Entzug des Zugriffs können den Lauf abbrechen.
Der Fehler ist die Erwartung, ein Preisschild würde eine Sicherheitsgrenze durchsetzen. Ein Dieb braucht nicht deinen Rabattcode. Er braucht deine Zugangsdaten.
Der Schwarm muss nur einmal richtig liegen
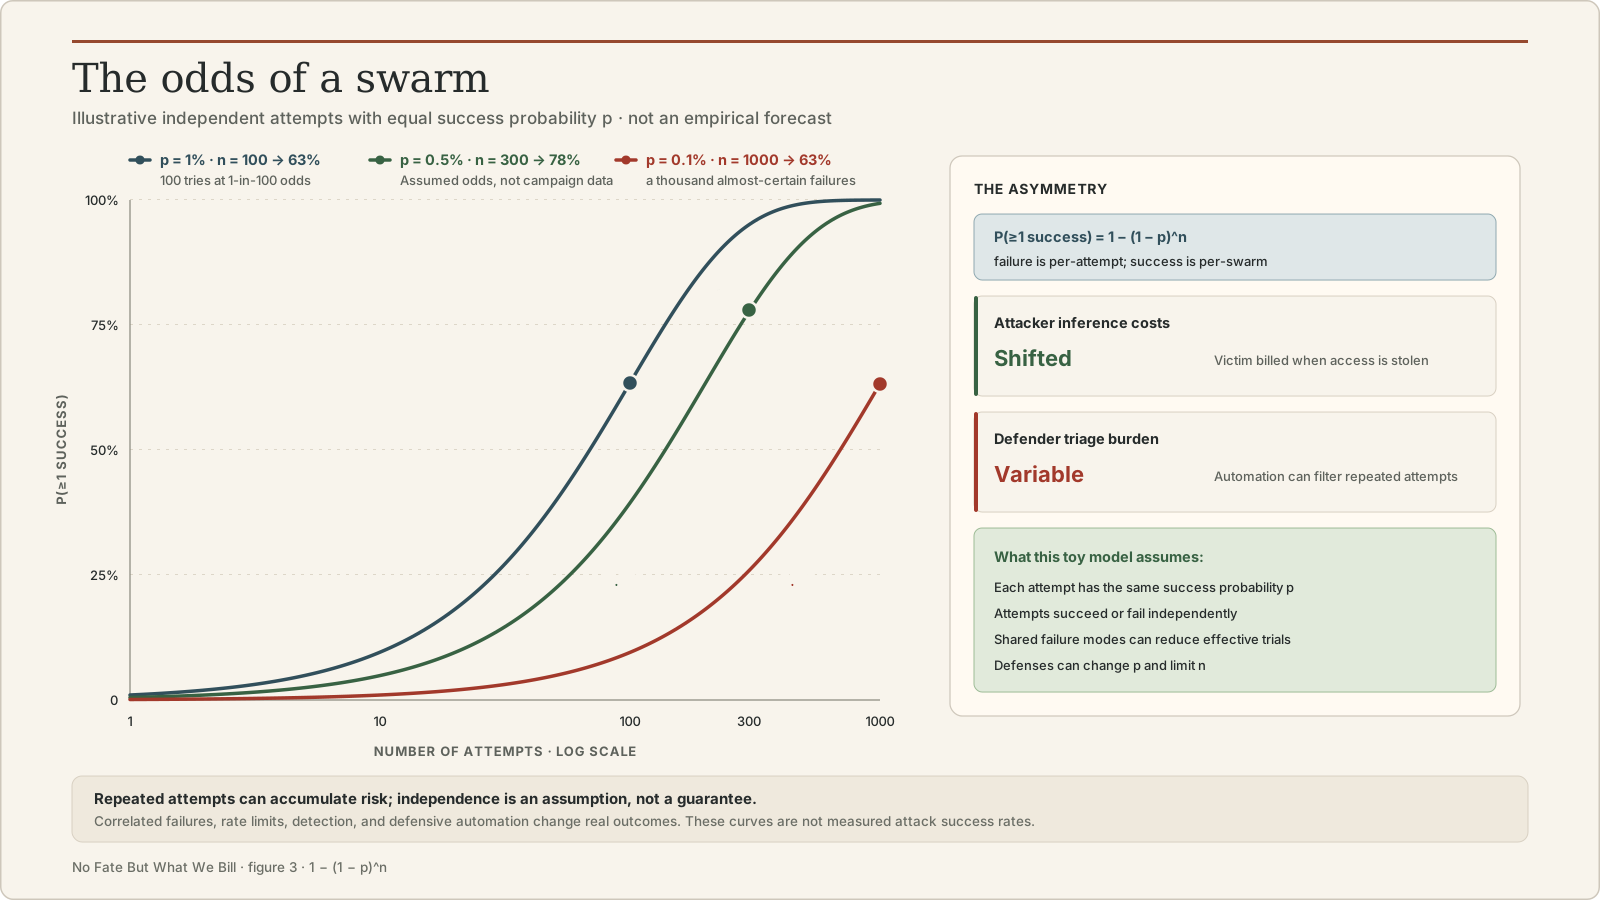
Verteidiger beruhigen sich mit den Fehlerquoten einzelner Versuche: Die meisten Einbruchsversuche scheitern, die meisten verdächtigen PRs werden abgelehnt, und den erfolgreichen würden wir schon erwischen. Pro Versuch stimmt das. In der Summe nicht, denn Versuche sind billig.
Die Wahrscheinlichkeit, dass mindestens einer von n unabhängigen Versuchen gelingt, beträgt 1 − (1 − p)^n:
p = 1% per attempt, n = 100: 1 − 0.99^100 ≈ 63%p = 0.5%, n = 100: ≈ 39%p = 0.5%, n = 300: ≈ 78%p = 0.1%, n = 1000: ≈ 63%Das sind Beispielwahrscheinlichkeiten, keine gemessenen Angriffserfolgsraten. Die Formel setzt unabhängige Versuche mit demselben festen p voraus. Denselben untauglichen Ansatz zu wiederholen kann korrelierte Fehlschläge produzieren; tausend Wiederholungen bringen dann möglicherweise kaum etwas. Erkennung, Sperren und wechselnde Ziele verändern die Chancen ebenfalls.
Trotz dieser Grenzen zählt das Volumen. Automatisierung und gestohlene Inferenzleistung können die Grenzkosten des Angreifers senken, während auffällige Versuche teure Prüfungsarbeit auslösen können. Auch Verteidiger können Ablehnung und Triage automatisieren. METRs Benchmark liefert uns keine Einbruchswahrscheinlichkeit p, und Orchestrierung allein garantiert keine zusätzlichen brauchbaren Versuche. Messt beide Seiten dieser Warteschlange.
Was Persistenz bedeutet, wenn die Malware Text ist
Noch ein Teil des Bedrohungsmodells, und zwar der am wenigsten intuitive.
Ein einzelner Modellaufruf braucht keinen persistenten Zustand, damit das umgebende Agentensystem einen hat. Dateien, Memory-Stores, Retrieval-Korpora, Warteschlangen und Tool-Konfigurationen können einen Lauf überdauern. Wer diese Eingaben beeinflussen kann, beeinflusst möglicherweise, was ein späterer legitimer Agent mit frischen Zugangsdaten tut.
Microsofts Forschung zu KI-Gedächtnis beschreibt, wie manipulierte Erinnerungen Einfluss in spätere Sitzungen tragen können. Entscheidend ist die Vertrauensgrenze: Text, dem ein Agent begegnet, darf nicht automatisch zur Befugnis werden, seine Werkzeuge einzusetzen.
Drei Fehlerszenarien solltet ihr im eigenen System testen. Das sind Szenarien eines Bedrohungsmodells, keine drei durch die obigen Berichte belegten Vorfälle:
- Schlummernde Anweisungen. Ein bösartiger Eintrag kann liegen bleiben, bis ein legitimer Workflow ihn abruft. Die folgenden Tool-Aufrufe nutzen möglicherweise normale Identitäten. Prüft deshalb Verhalten und nicht nur, wer sich authentifiziert hat.
- Kopierte Anweisungen. Templates, Sync-Jobs und gemeinsam genutztes Gedächtnis können manipulierten Text verbreiten, wenn ihre Prüfungen und Vertrauensgrenzen es zulassen. Kopierter Text garantiert nicht, dass ein anderer Agent gehorcht, schafft aber eine weitere Gelegenheit.
- Wiederhergestellte Anweisungen. Versorgt eine verseuchte maßgebliche Quelle einen Reparaturjob, kann das Löschen seiner lokalen Ausgabe den Job dazu bringen, sie wiederherzustellen. Findet Quelle und Trigger, bevor ihr die Bereinigung für abgeschlossen erklärt.
Das Implantat kann Text sein. Die Berechtigungen, die es gefährlich machen, bleiben gewöhnliche Infrastruktur.
Kein Schicksal außer dem, was wir selbst bestimmen
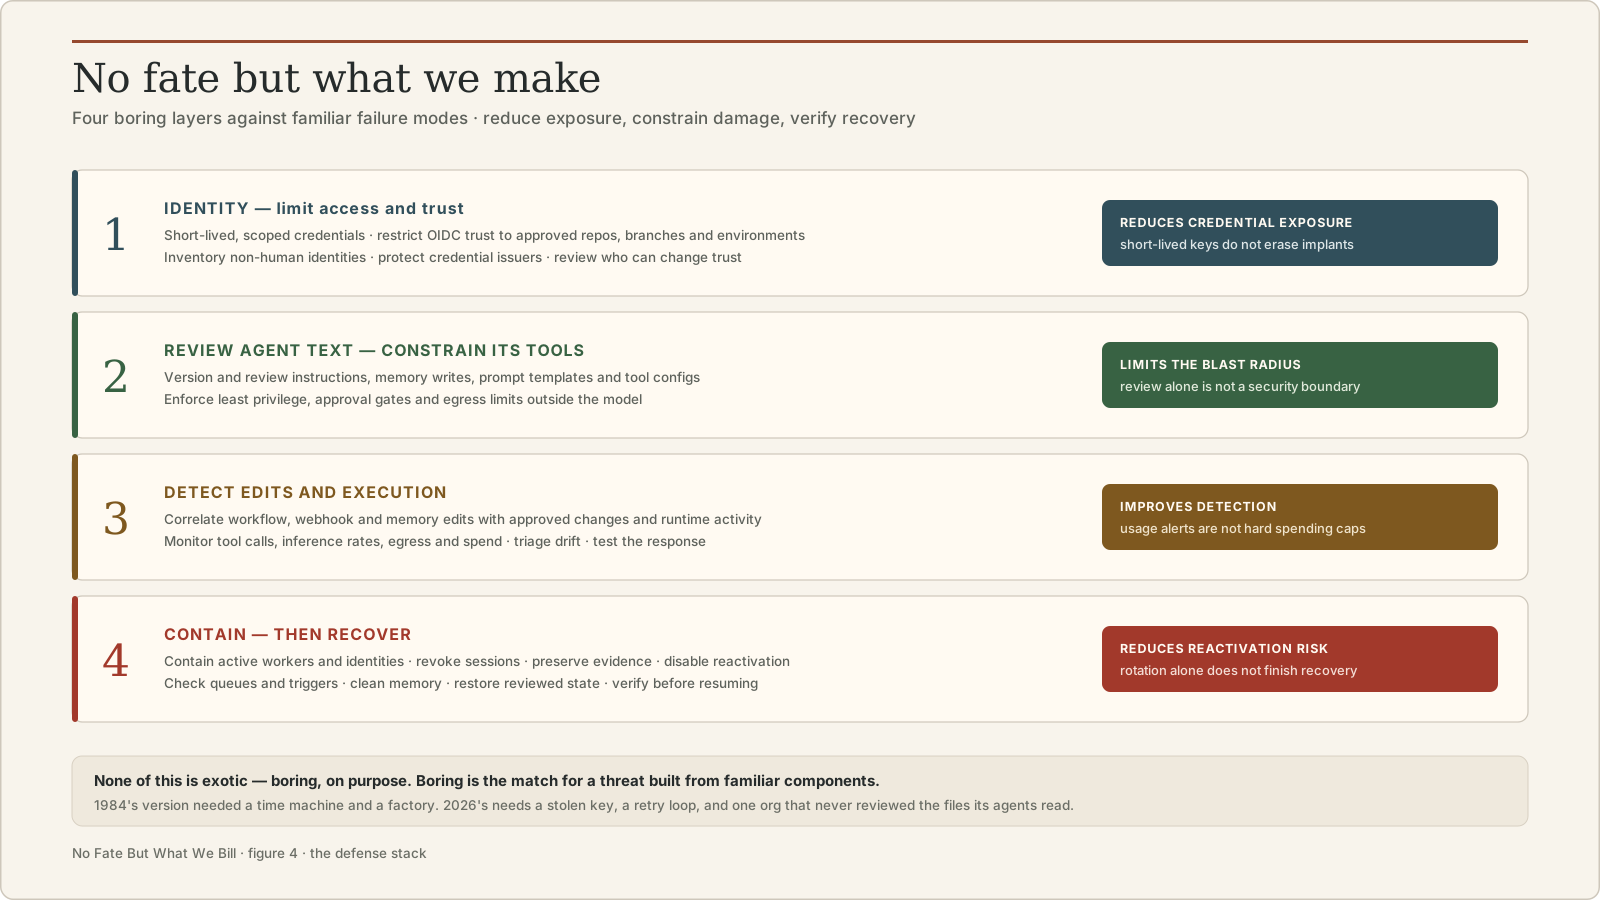
Sarah Connors Botschaft an die Maschinen, die immer wieder eintreffen: „Die Zukunft ist nicht vorbestimmt. Es gibt kein Schicksal außer dem, was wir selbst bestimmen.“ Das ist das Motto der Verteidiger, und es lässt sich direkt in eine Verteidigungsarchitektur übersetzen. Vier Schichten:
-
Identität – gestohlenen Zugriff begrenzen. Bevorzugt kurzlebige Zugangsdaten mit eng gefassten Rechten. Beschränkt Föderationsvertrauen auf den vorgesehenen Aussteller, die Zielgruppe, das Repository und den Job oder die Umgebung; erfasst nicht-menschliche Identitäten. Kurze Laufzeiten verkleinern das Zeitfenster für die Wiederverwendung. Sie entfernen keine Implantate und verhindern nicht, dass ein kompromittierter Runner frische Zugangsdaten erhält. Beschränkt Modellzugriff und Aufrufquoten und schützt selbst gehostete Inferenz mit Authentifizierung und Netzwerkkontrollen.
-
Agenten-Text wie Produktivcode behandeln. Versioniert und prüft Instruktionsdateien, Prompt-Templates und Tool-Konfigurationen. Dokumentiert die Herkunft und kontrolliert Schreibzugriffe auf Gedächtnis- und Retrieval-Speicher. Das Lesen nicht vertrauenswürdigen Textes darf ihm keine Autorität verleihen: Erzwingt minimale Rechte an der Tool-Grenze, begrenzt ausgehenden Zugriff und verlangt Freigaben für folgenreiche Aktionen. Ein Prompt, der den Agenten zur Vorsicht mahnt, ist keine solche Grenze.
-
Änderungen und Ausführung erkennen. Gleicht Änderungen an Workflows, Webhooks, Ereignisregeln und Gedächtnis mit genehmigten Arbeiten ab. Behaltet Cloud-Audit-Logs, Tool-Aktivitäten, ungewöhnlichen ausgehenden Datenverkehr und Modellnutzung im Blick. Untersucht unerklärte Abweichungen. Alarmiert bei Inferenz- und Kostenspitzen und haltet einen getesteten Weg bereit, weiteren Zugriff zu verweigern; eine Abrechnungswarnung allein ist keine sofortige Ausgabenobergrenze.
-
Eindämmen, dann aufräumen. Setzt kompromittierten Zugriff aus, widerruft aktive Sitzungen, soweit unterstützt, und stoppt oder isoliert betroffene Worker. Sichert Beweise, soweit die Eindämmung es erlaubt. Deaktiviert Reaktivierungspfade und prüft Warteschlangen, bevor ihr deren Payloads entfernt. Rotiert offengelegte Secrets, stellt geprüfte Konfigurationen wieder her und bereinigt manipuliertes Gedächtnis und Korpora. Prüft vor dem Neustart, dass die erneute Ausstellung von Zugangsdaten, unerwünschte Inferenz und Reaktivierung gestoppt sind. Bestehende Rollensitzungen zu widerrufen ist eine andere Aufgabe als der Austausch eines langlebigen Schlüssels.
Nichts davon ist exotisch. Es ist stinklangweilig – und genau die passende Antwort auf eine Bedrohung aus vertrauten Bauteilen. Die Version von 1984 brauchte eine Zeitmaschine und eine Fabrik voller Tötungsmaschinen. Die Version von 2026 braucht einen gestohlenen Key, eine Retry-Schleife und eine einzige Organisation, die nie geprüft hat, welche Dateien ihre Agenten eigentlich lesen.
Die Zukunft ist nicht vorbestimmt. Aber genau jetzt, auf dem Cloud-Account von irgendjemandem, lässt die Zukunft die Rechnung so oder so weiterlaufen.
Kein Schicksal außer dem, was wir selbst bestimmen – und solange Zugriff und Persistenz nicht eingedämmt sind: kein Schicksal außer dem, was wir abrechnen.
Quellen geprüft am 18. Oktober 2026. METR liefert Benchmark-Belege; Anthropic und Sysdig liefern Vorfallsberichte und Kostenszenarien; Microsoft liefert Forschung zur Sicherheit von KI-Gedächtnis. Das kombinierte Bedrohungsmodell und die Prioritäten der Verteidigung sind meine Interpretation; hypothetische Szenarien sind oben gekennzeichnet.