
算力不息,扣费不止
智能体越跑越久,集群越铺越广,云密钥一被盗,算力账单就落到受害者头上。

“听着,听明白了。那个终结者就在外面。你没法跟它谈条件, 也没法跟它讲道理。它没有怜悯,没有悔恨,也没有恐惧。而且, 只要你还活着,它就绝对不会停下,永远不会。”
凯尔·里斯,向 1984 年的观众介绍威胁到底长什么样。
这段话里,经得起时间检验的不是杀人数,而是“绝对不会停下”。 终结者吓人,从来不是因为它聪明。而是其他一切都失效后, 它还在继续干活。耐力才是威胁。
后来,这个系列纠正了自己的错误。没人会连看三部电影, 都只怕一台机器人。真正的反派是天网:一个拥有计算核心、 工厂和时间位移设备的分布式系统。机器人不过是一次 API 调用。
到了 2026 年,那些不太有电影感的版本已经值得认真对待:智能体处理更难的任务,软件协调针对多个目标的工作,被盗的云访问权限把账单送到别人的账户上。“绝对不会停下”,如今也有了财务部门的解读。
这篇文章要讲的,是我一直对那些认定智能体威胁只是炒作的团队说的话:危险的作业模式不需要一次惊天突破。能力更强的智能体、可重复的编排,以及被盗的模型访问权限,可以相互增强。跑表的钱未必由攻击者付。 这是威胁模型,不是实测得出的攻击指数增长定律。
曲线一:耐力
METR 于 2025 年 3 月发表的时间跨度研究发现:智能体以 50% 可靠性完成的软件任务,按人类基准衡量的任务时长大约每七个月翻一番。单位很重要:是人完成任务的时间,不是智能体无人看管地运行了多少小时。 两小时的时间跨度,指人类专家大约花两小时完成的任务;在该任务分布下,预测智能体有一半的概率成功。
METR 的测量页面解释了局限:这些主要是定义清楚的软件任务,面对更混乱的工作,表现可能更差;使用这套测试,超过十六小时的估计并不可靠。页面最后更新于 2026 年 9 月 8 日,已不再主动维护。它证明任务能力在提高,但并不承诺下一代模型就能可靠地接管你一整天的事件响应。
分清这些,实际运营中的担忧依然存在。重试循环可以不断要求一个有能力的智能体干活。能否取得进展,取决于任务、反馈、权限和预算。皮夹克仍是选配。
曲线二:广度
只有耐力,不过是多了一个极有耐心的员工。编排能把工作分派到队列中。
2025 年 11 月,Anthropic 披露了由 AI 编排的间谍行动 GTG-1002。根据其调查,攻击者围绕 Claude Code 构建了一套框架,尝试侵入约三十个目标,在少数情况下成功。他们使用越狱手法,把恶意子任务伪装成合法的安全工作。目标选择和重要决策仍由人负责;模型也捏造过一些结果。
这是一份严肃的实际滥用报告。它没有测量三十个子智能体同时运行的情况,没有证明自行传播的蠕虫存在,也没有证明所有安全控制都失效了。真正有用的结论更有限:攻击者的框架可以把大量工作委派给商业智能体。
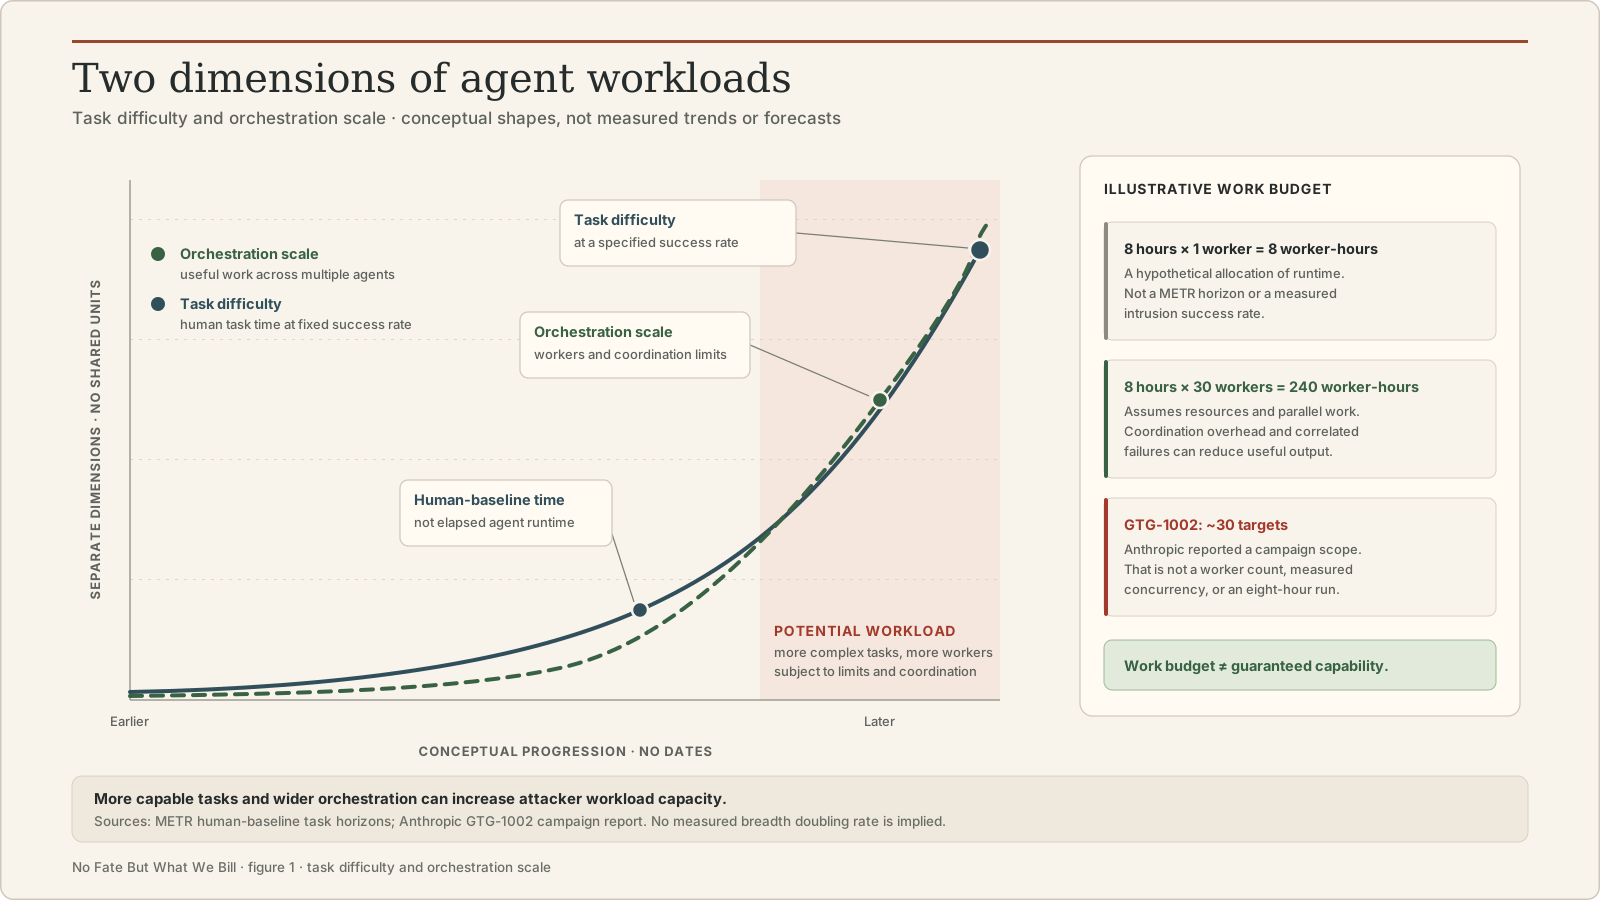
做容量规划时,八个工作单元各运行一小时,消耗八个工作单元小时。这道算术本身并不能说明入侵能否成功。协调开销、相关性错误、配额,以及防守方的自动化,都会改变结果。安全团队该问的是:在恶意工作进入人工队列之前,自己的控制措施能拦下多少。
谁来付账
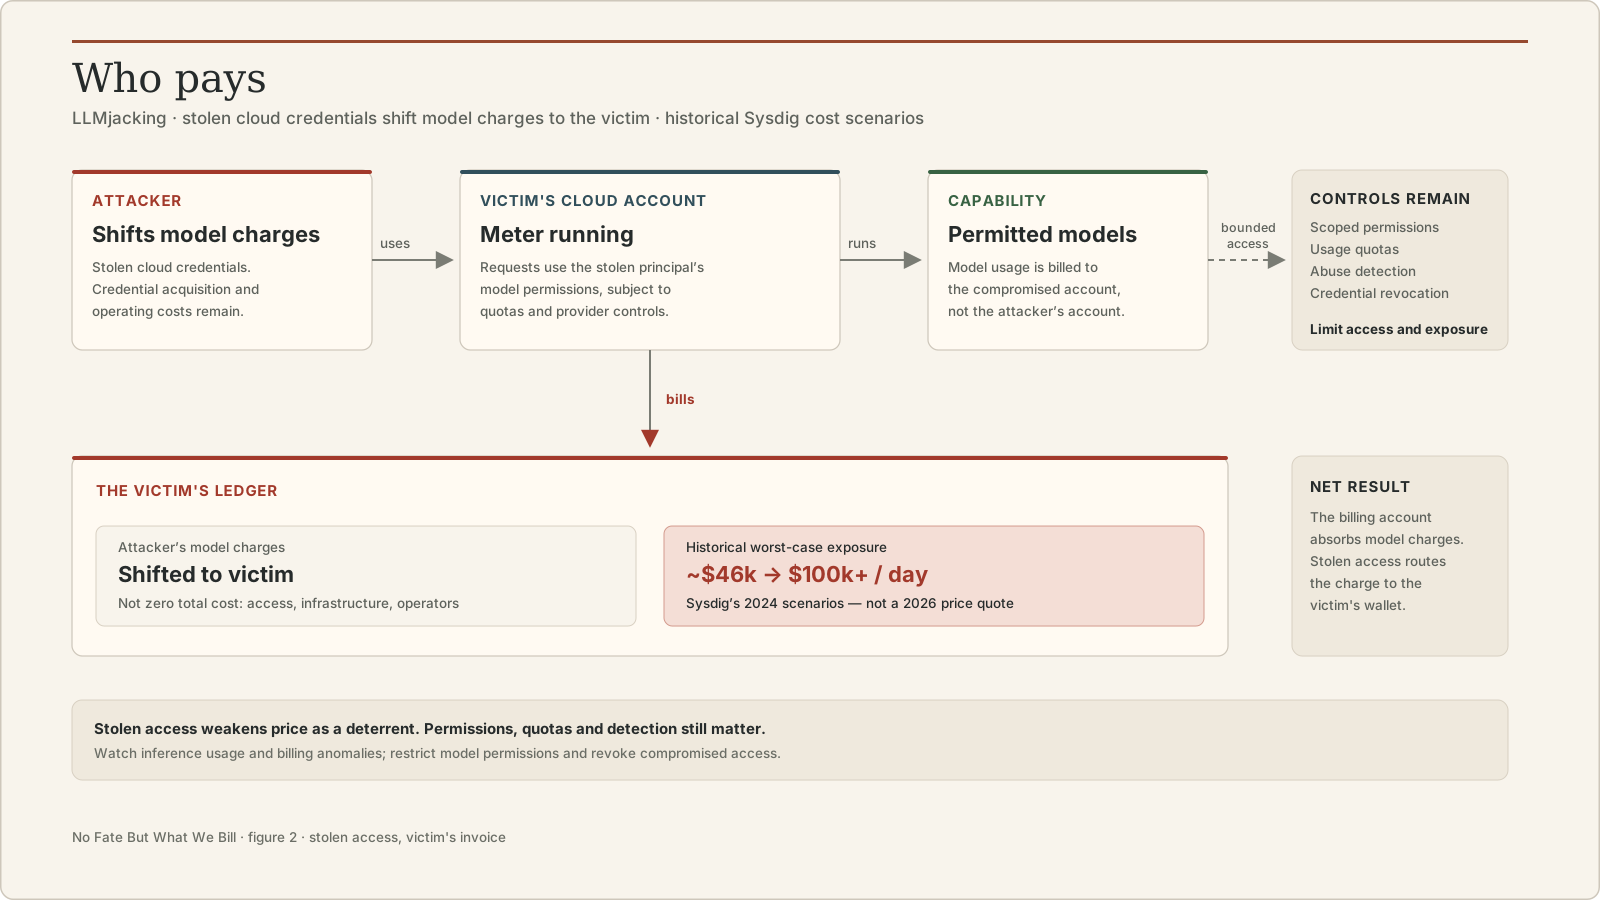
Sysdig 于 2024 年 5 月发布的 LLMjacking 报告描述了攻击者利用被盗云凭据访问模型服务、由受害者承担费用的情况。其模型估算的潜在费用超过每天 4.6 万美元;2024 年 9 月的后续报告描述了使用更贵模型时,每天可能超过 10 万美元的费用。这些是历史成本情景,不是典型损失,也不是 2026 年的报价。
它与智能体工具之间也有具体联系。2026 年 6 月,Sysdig 观察到一名使用者借助暴露在外的 Ollama 服务器,开发自动化进攻性安全工具。观察到的目标都是私人练习环境;研究人员明确表示,工具最终用途尚不清楚。这个案例说明,被盗的推理资源可以支持工具开发,并不代表已确认其针对公网受害者发动了攻击。
被盗访问权限削弱了价格的威慑作用:受害者收到模型账单。但攻击者的基础设施、凭据获取和监督成本不会因此消失。账户权限、模型访问限制和配额也不会被绕过。这些控制仍在限制被盗身份能做什么;检测和撤销访问权限可以提前终止运行。
错误在于指望价格标签替你执行安全边界。窃贼不需要你的优惠码。他们需要的是你的凭据。
集群只需成功一次
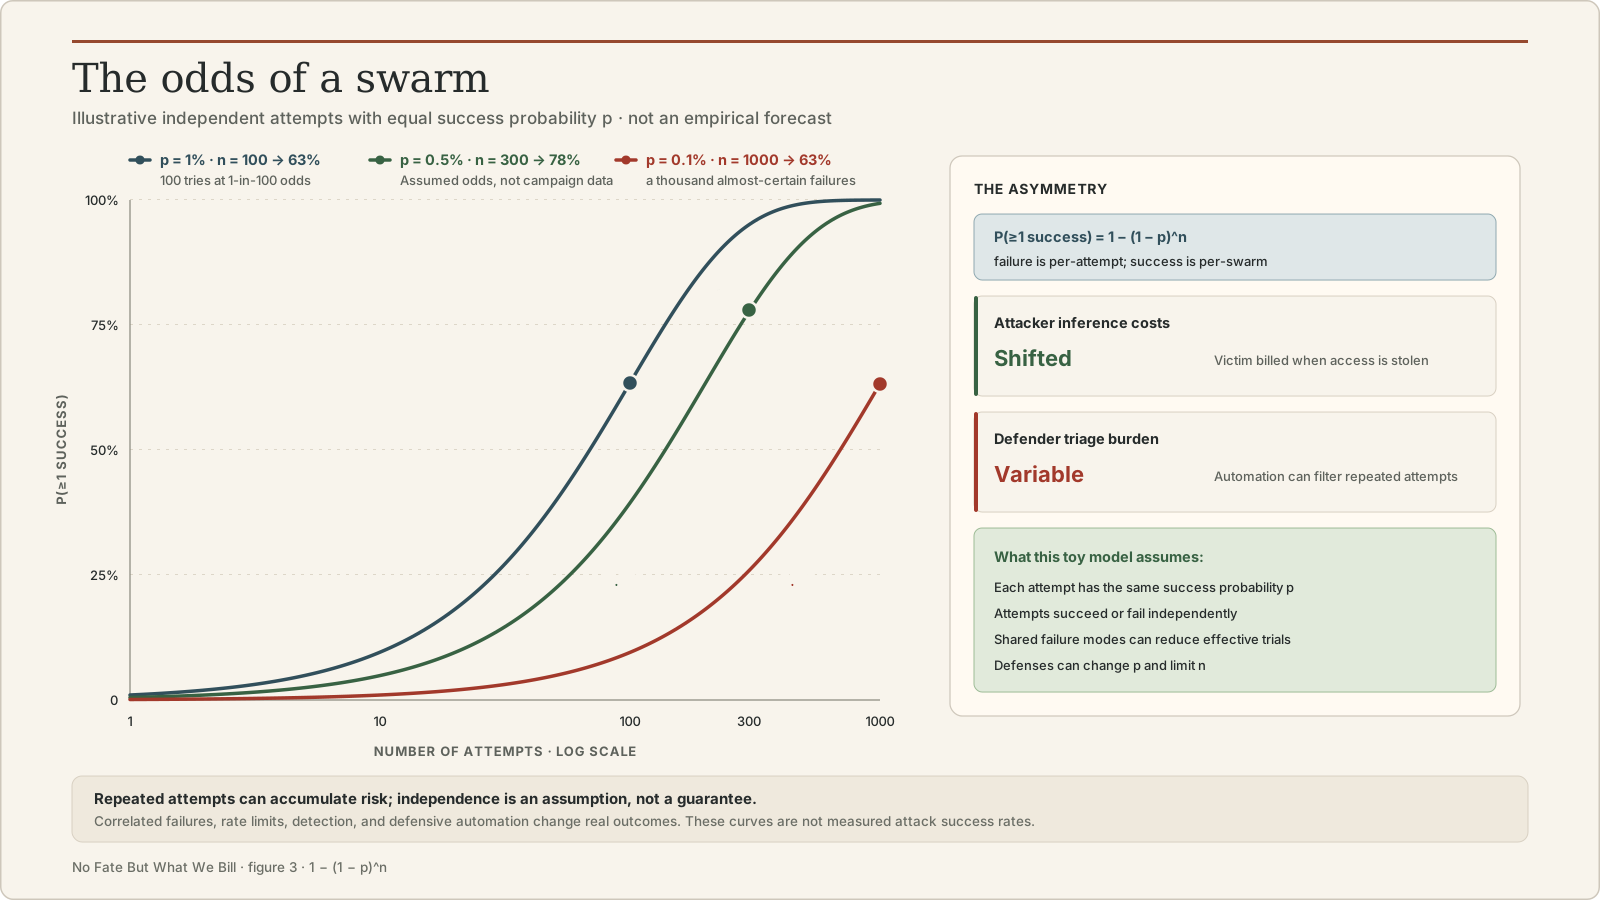
防守方拿单次尝试的失败率安慰自己:大多数入侵尝试都失败了,大多数可疑 PR 都被拒了,真有成功的,我们也能抓住。按单次算,没错。合起来看,就错了,因为尝试太便宜。
n 次独立尝试中至少一次成功的概率是 1 − (1 − p)^n:
p = 1% per attempt, n = 100: 1 − 0.99^100 ≈ 63%p = 0.5%, n = 100: ≈ 39%p = 0.5%, n = 300: ≈ 78%p = 0.1%, n = 1000: ≈ 63%这些是简化示例中的概率,不是实测攻击成功率。公式假设各次尝试相互独立,且 p 固定不变。反复使用同一个行不通的方法,可能产生相关的失败;重试一千次也未必多大用。检测、锁定和更换目标也会改变概率。
即便有这些限制,数量依然重要。自动化和被盗推理资源可以降低攻击者的边际成本,嘈杂的尝试则可能带来昂贵的审查工作。防守方同样可以自动拒绝和分流。METR 的基准测试没有告诉我们入侵概率 p,编排本身也不保证能增加有效尝试。队列两端都要测量。
当恶意软件是文本,持久化意味着什么
威胁模型还差一块,也是最反直觉的一块。
单次模型调用不需要持久状态,包围它的智能体系统却可以拥有持久状态。文件、记忆存储、检索语料库、队列和工具配置,都可能在一轮运行结束后继续存在。能影响这些输入的攻击者,可能影响未来的合法智能体拿着新凭据做什么。
微软关于 AI 记忆的研究描述了被污染的记忆如何把影响带到后续会话。关键在于信任边界:智能体遇到的文本,不能自动获得调用其工具的权限。
有三种失效模式值得在自己的系统里测试。它们是威胁模型中的情景,不是上述报告已经证实的三起事件:
- 休眠的指令。 恶意条目可以一直留着,直到合法工作流检索到它。随后的工具调用可能使用正常身份,因此既要检查谁通过了身份验证,也要检查行为。
- 被复制的指令。 如果审查机制和信任边界允许,模板、同步任务和共享记忆就可能传播被污染的文本。复制文本不保证另一个智能体会服从,但会多创造一次机会。
- 被恢复的指令。 如果自动修复任务依赖的权威数据源已经被污染,删除它在本地生成的内容,可能让任务再次恢复这些内容。在宣布清理完成前,先找出源头和触发器。
植入体可以是文本。让它变得危险的权限,依然属于普通基础设施。
命运掌握在自己手中
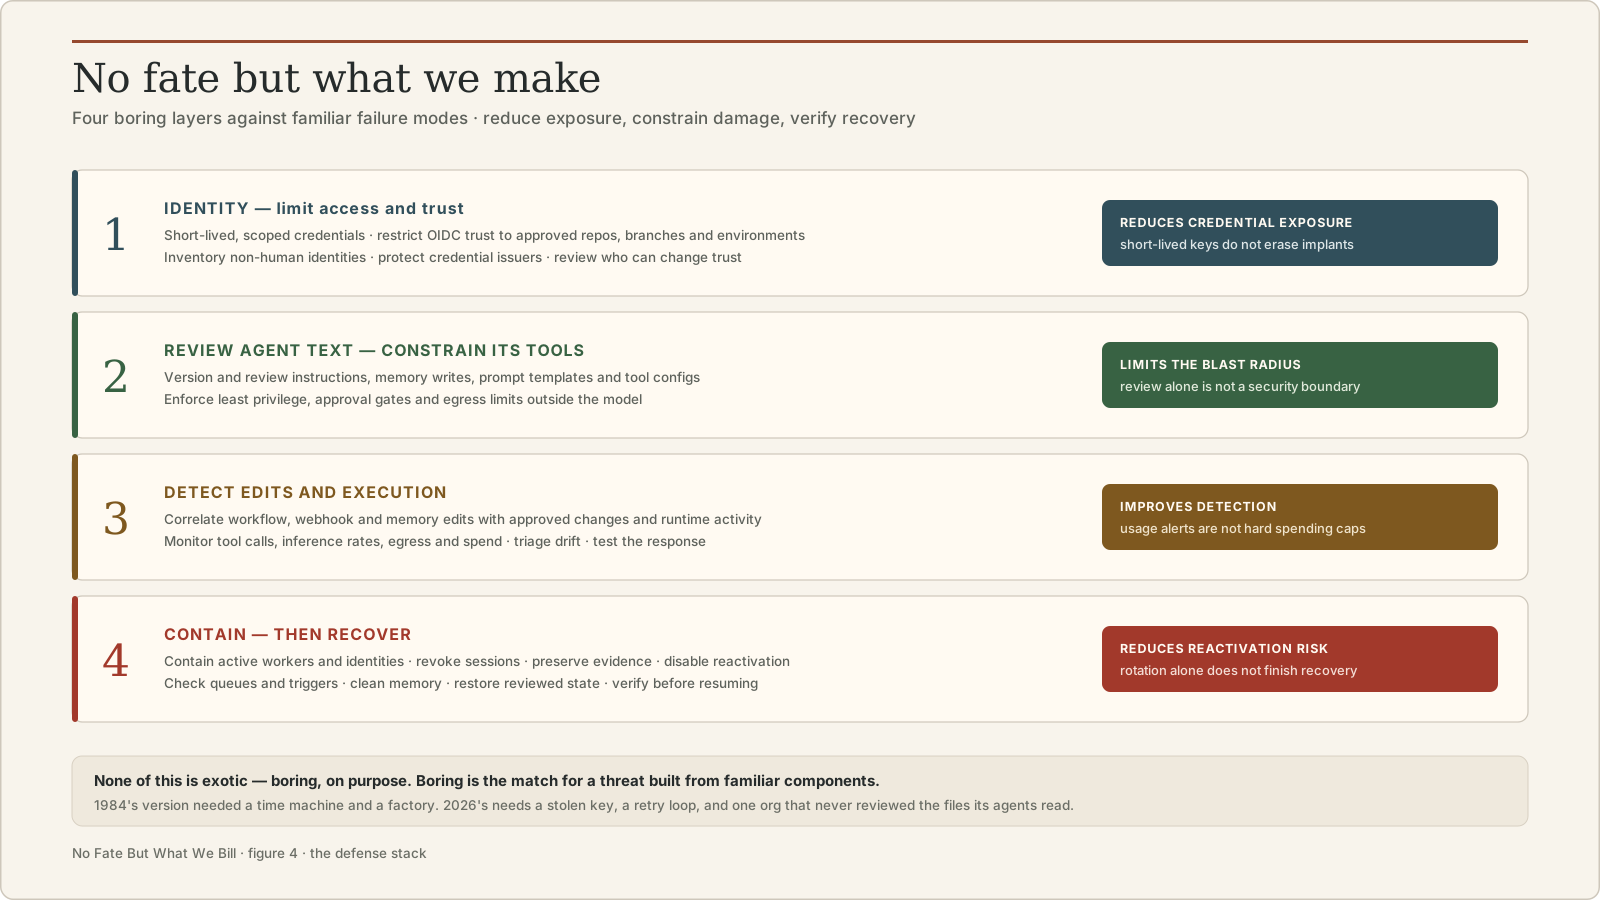
莎拉·康纳把这句话传给那些不断到来的机器:“未来尚未注定。命运掌握在自己手中。”这是防守方的台词,也能直接落成防御架构。四层:
-
身份——缩小被盗访问权限的范围。 优先使用短期、权限范围狭窄的凭据。将联合身份信任限制在预期的签发方、受众、仓库及任务或环境;建立非人类身份清单。短有效期会缩小重放窗口,但不会清除植入体,也不能阻止已失陷的执行器获取新凭据。限制模型访问和调用配额,并用身份验证和网络控制保护自托管推理服务。
-
把智能体文本当作生产代码。 对指令文件、提示词模板和工具配置进行版本控制与审查。记录来源,控制对记忆和检索存储的写入。读取不可信文本不能让它获得权限:在工具边界执行最小权限原则,限制出站访问,对后果重大的操作要求批准。让智能体“小心一点”的提示词,不是这样的边界。
-
检测修改与执行。 将工作流、webhook、事件规则和记忆的变更与获批工作关联起来。持续关注云审计日志、工具活动、异常出站流量和模型用量。调查无法解释的漂移。对推理用量和支出激增告警,并准备经过测试的办法来阻断后续访问;仅有账单告警,并不等于立即生效的支出上限。
-
先遏制,再清理。 暂停已失陷的访问权限,在支持的情况下撤销活动会话,停止或隔离受影响的工作单元。在不妨碍遏制的前提下保全证据。清除有效载荷前,先禁用重新激活的路径,并核查、处理队列。轮换已暴露的秘密信息,恢复审查过的配置,修复被污染的记忆和语料库。恢复运行前,确认新凭据签发、非预期推理和重新激活都已停止。撤销现有角色会话与替换长期密钥是两回事。
这些都不是什么新奇技术。很无聊,但面对由熟悉组件拼起来的威胁,这才对路。1984 年的版本需要一台时间机器,外加一整座生产杀人机器的工厂。2026 年的版本只需要一把偷来的密钥、一个重试循环,以及一家从未审查过智能体所读文件的组织。
未来尚未注定。但眼下,在某个人的云账户上,不管结局如何,未来都在跑表扣费。
命运掌握在自己手中——而在访问权限与持久化机制被控制住之前,算力不息,扣费不止。
来源核查于 2026 年 10 月 18 日。METR 提供基准测试证据;Anthropic 和 Sysdig 提供事件报告及成本情景;微软提供记忆安全研究。组合后的威胁模型和防御优先级是我的解读,假设情景已在上文标明。