
Nessun destino se non quello che fatturiamo
Gli agenti lavorano sempre più a lungo, gli sciami si espandono e le chiavi cloud rubate scaricano il conto del compute sulla vittima.

“Ascolta e cerca di capire. Quel Terminator è là fuori. Non puoi trattare con lui. Non puoi farlo ragionare. Non prova pietà, né rimorso, né paura. E non si fermerà assolutamente mai, finché non sarai morto.”
Kyle Reese, mentre spiega al pubblico del 1984 che forma ha la minaccia.
La battuta che ha retto al tempo non è il numero di vittime. È “non si fermerà assolutamente mai”. Terminator non ha mai fatto paura perché era intelligente. Faceva paura perché continuava a funzionare dopo che tutto il resto aveva fallito. La minaccia era la resistenza.
Poi la saga ha corretto il proprio errore. Nessuno passa tre film a temere un solo robot. Il vero cattivo è Skynet: un sistema distribuito con nuclei di elaborazione, fabbriche e apparati per il viaggio nel tempo. Il robot è una chiamata API.
Nel 2026, le versioni meno cinematografiche meritavano già di essere prese sul serio: agenti che affrontano compiti più difficili, software che coordina il lavoro su più obiettivi e accessi cloud rubati che addebitano il conto a qualcun altro. «Non si fermerà assolutamente mai» ha ormai un’interpretazione da ufficio contabilità.
Questo post espone l’argomento che continuo a ripetere ai team convinti che la minaccia agentica sia solo clamore: un modello operativo pericoloso non richiede una singola svolta spettacolare. Agenti più capaci, orchestrazione ripetibile e accessi rubati ai modelli possono rafforzarsi a vicenda. Chi attacca potrebbe non essere chi paga il consumo. È un modello di minaccia, non una legge misurata di crescita esponenziale degli attacchi.
Prima curva: resistenza
Lo studio di METR sull’orizzonte temporale del marzo 2025 ha rilevato un raddoppio all’incirca ogni sette mesi della durata, misurata rispetto a un riferimento umano, dei compiti software che gli agenti potevano completare con un’affidabilità del 50%. L’unità conta: tempo necessario a un essere umano per il compito, non ore in cui un agente funziona senza supervisione. Un orizzonte di due ore indica un compito che richiede circa due ore a un esperto umano, con una probabilità prevista di successo dell’agente pari alla metà dei tentativi su quella distribuzione di compiti.
La pagina delle misurazioni di METR ne spiega i limiti: si tratta soprattutto di compiti software ben definiti, le prestazioni su lavori meno strutturati possono essere peggiori e le stime oltre le sedici ore non sono affidabili con quella suite di test. La pagina è stata aggiornata per l’ultima volta l’8 settembre 2026 e non viene più mantenuta attivamente. È una prova di capacità crescenti nell’esecuzione dei compiti, non la promessa che il prossimo modello gestirà in modo affidabile la risposta agli incidenti per una giornata.
La preoccupazione operativa resta valida anche con questa distinzione. Un ciclo di tentativi può continuare a chiedere lavoro a un agente capace. Che faccia progressi dipende dal compito, dai riscontri sui risultati, dai permessi e dal budget. La giacca di pelle rimane facoltativa.
Seconda curva: ampiezza
La resistenza da sola equivale a un dipendente molto paziente. L’orchestrazione permette di distribuire il lavoro su una coda.
Nel novembre 2025, Anthropic ha reso nota una campagna di spionaggio orchestrata dall’IA, GTG-1002. Secondo la sua indagine, gli attaccanti hanno costruito un framework intorno a Claude Code e tentato di infiltrarsi in circa trenta obiettivi, riuscendoci in un numero ridotto di casi. Hanno usato jailbreak e mascherato sottocompiti malevoli come attività legittime di sicurezza. Gli esseri umani continuavano a scegliere gli obiettivi e prendere decisioni importanti; il modello ha anche inventato alcuni risultati.
È un resoconto serio di uso malevolo sul campo. Non è una misurazione di trenta sotto-agenti simultanei, la prova di un worm che si propaga da solo o la dimostrazione che ogni controllo di sicurezza fosse scomparso. La lezione utile è più circoscritta: il framework di un attaccante può delegare una quantità considerevole di lavoro a un agente commerciale.
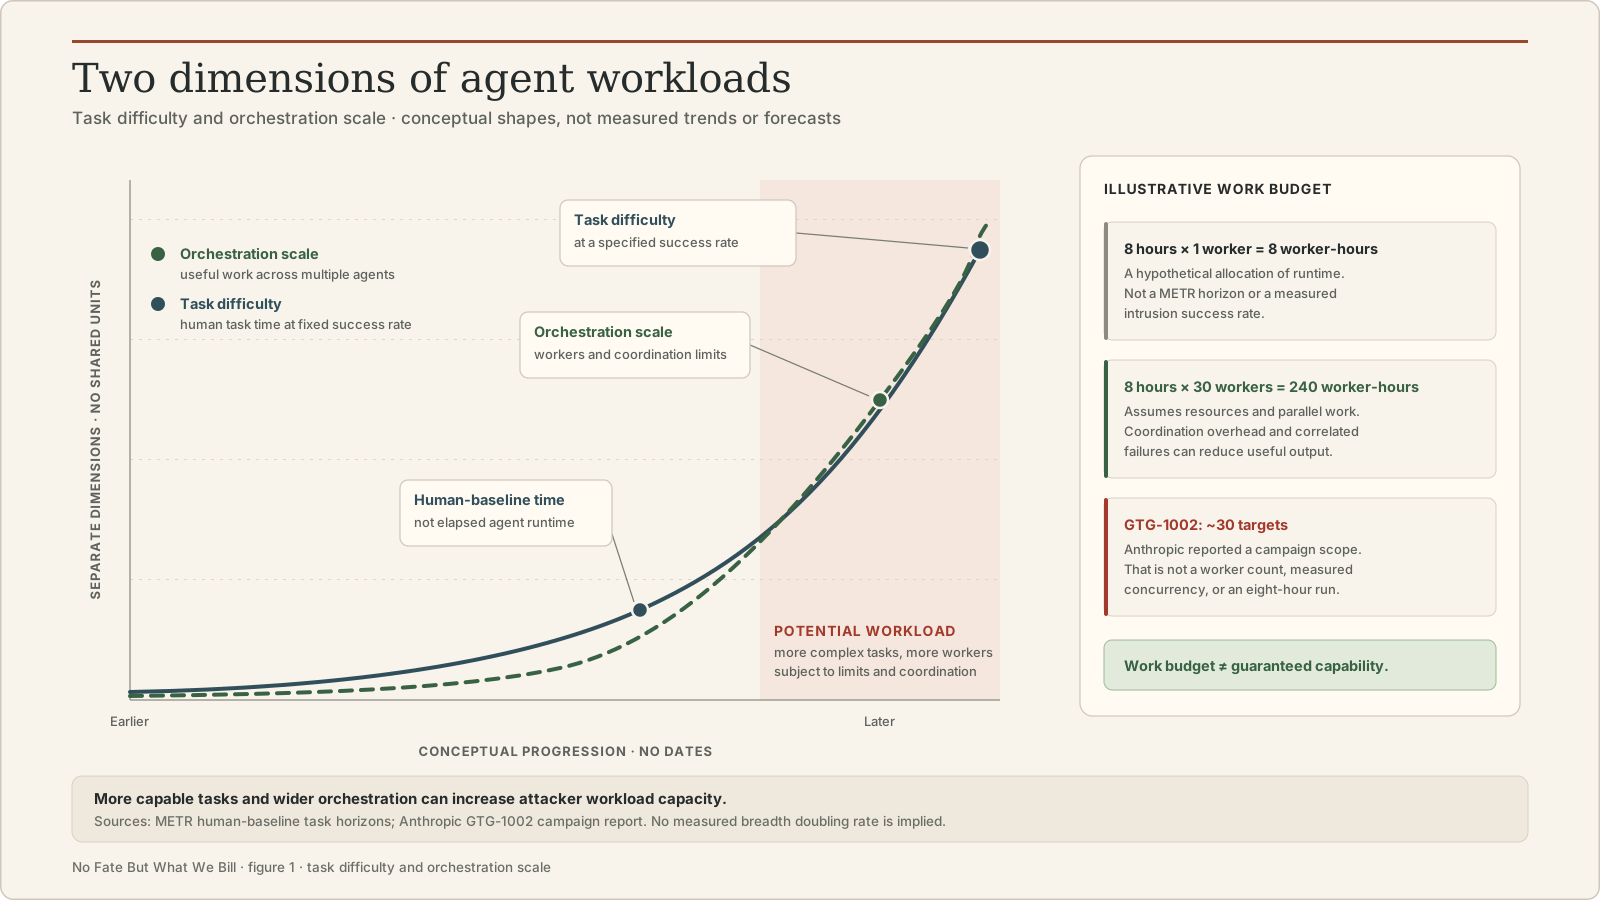
Per pianificare la capacità, otto esecutori attivi per un’ora consumano otto ore-esecutore. Questa aritmetica da sola non dice nulla sulle intrusioni riuscite. L’overhead di coordinamento, gli errori correlati, le quote e l’automazione dei difensori cambiano tutti il risultato. La domanda per un team di sicurezza è quanto lavoro ostile i suoi controlli riescano a respingere prima che finisca in una coda da esaminare per una persona.
Chi paga
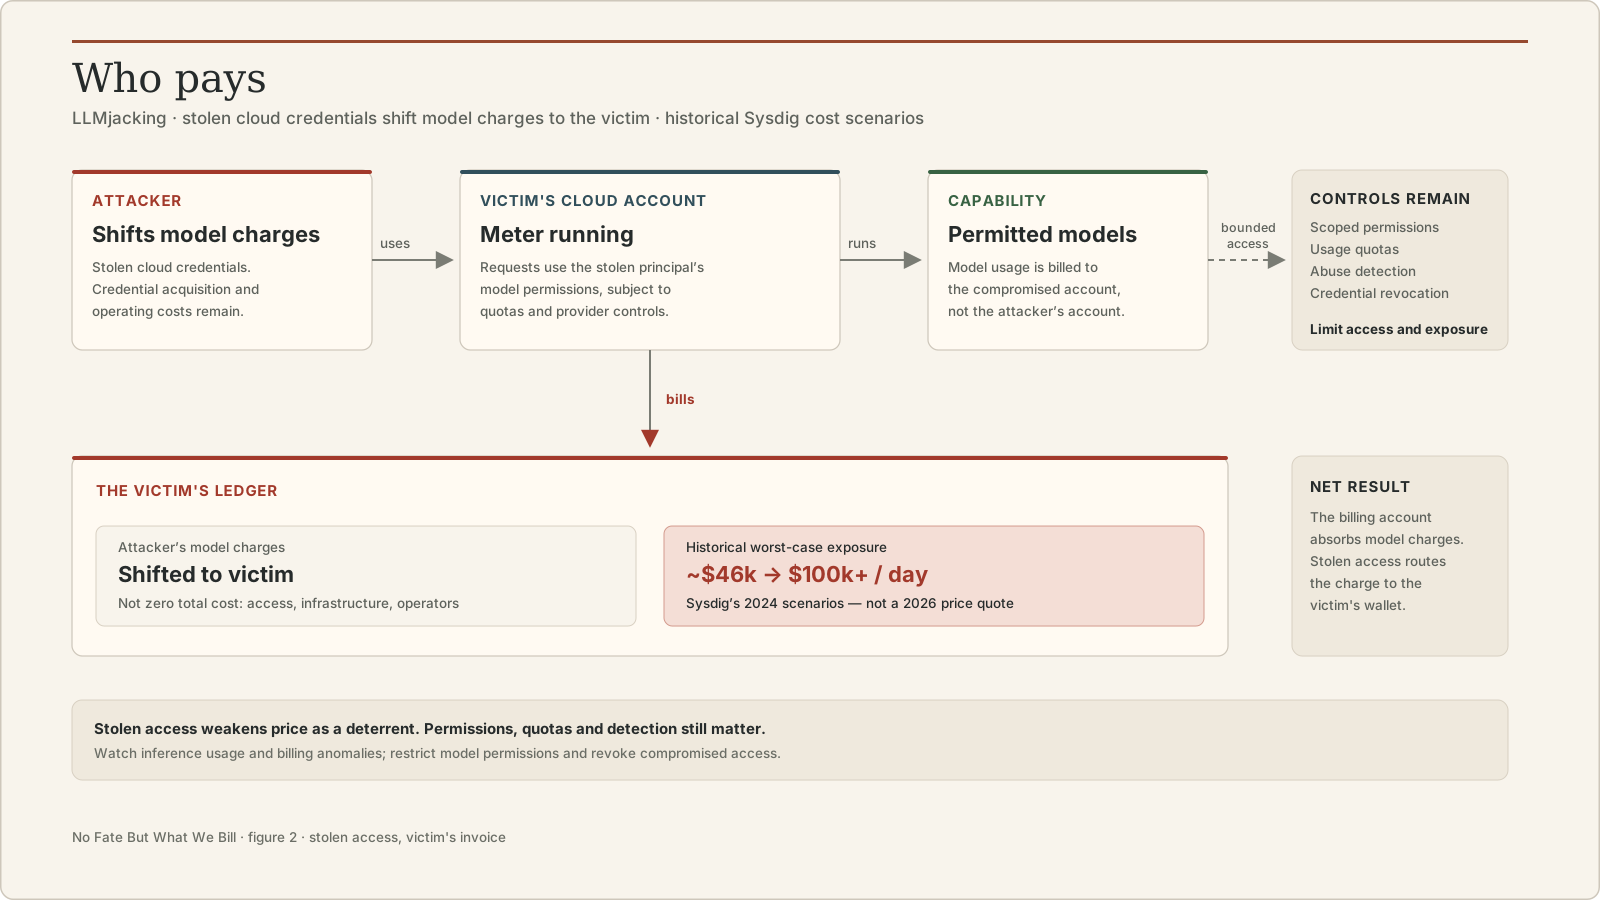
Il rapporto di Sysdig sul LLMjacking del maggio 2024 descriveva l’uso di credenziali cloud rubate per accedere ai servizi dei modelli a spese della vittima. L’esposizione economica modellata superava i 46.000 dollari al giorno; un aggiornamento del settembre 2024 descriveva costi potenziali superiori a 100.000 dollari al giorno con modelli più costosi. Sono scenari di costo storici, non perdite tipiche né un listino del 2026.
Esiste anche un collegamento concreto con gli strumenti agentici. Nel giugno 2026, Sysdig ha osservato un attore usare un server Ollama esposto per sviluppare uno strumento automatizzato di sicurezza offensiva. Gli obiettivi osservati erano ambienti privati di esercitazione; i ricercatori hanno esplicitamente lasciato irrisolta la questione dell’intento finale dello strumento. Il caso mostra inferenza rubata a supporto dello sviluppo di strumenti, non una campagna confermata contro vittime pubbliche.
L’accesso rubato indebolisce il prezzo come deterrente: gli addebiti del modello arrivano alla vittima. Non rende gratuiti l’infrastruttura dell’attaccante, l’acquisizione delle credenziali o la supervisione. Né aggira i permessi dell’account, le restrizioni di accesso ai modelli o le quote. Questi controlli continuano a limitare ciò che può fare l’identità rubata; il rilevamento e la revoca possono interrompere l’esecuzione.
L’errore è aspettarsi che un cartellino del prezzo faccia rispettare un confine di sicurezza. A un ladro non serve il tuo codice sconto. Gli servono le tue credenziali.
Allo sciame basta riuscire una volta
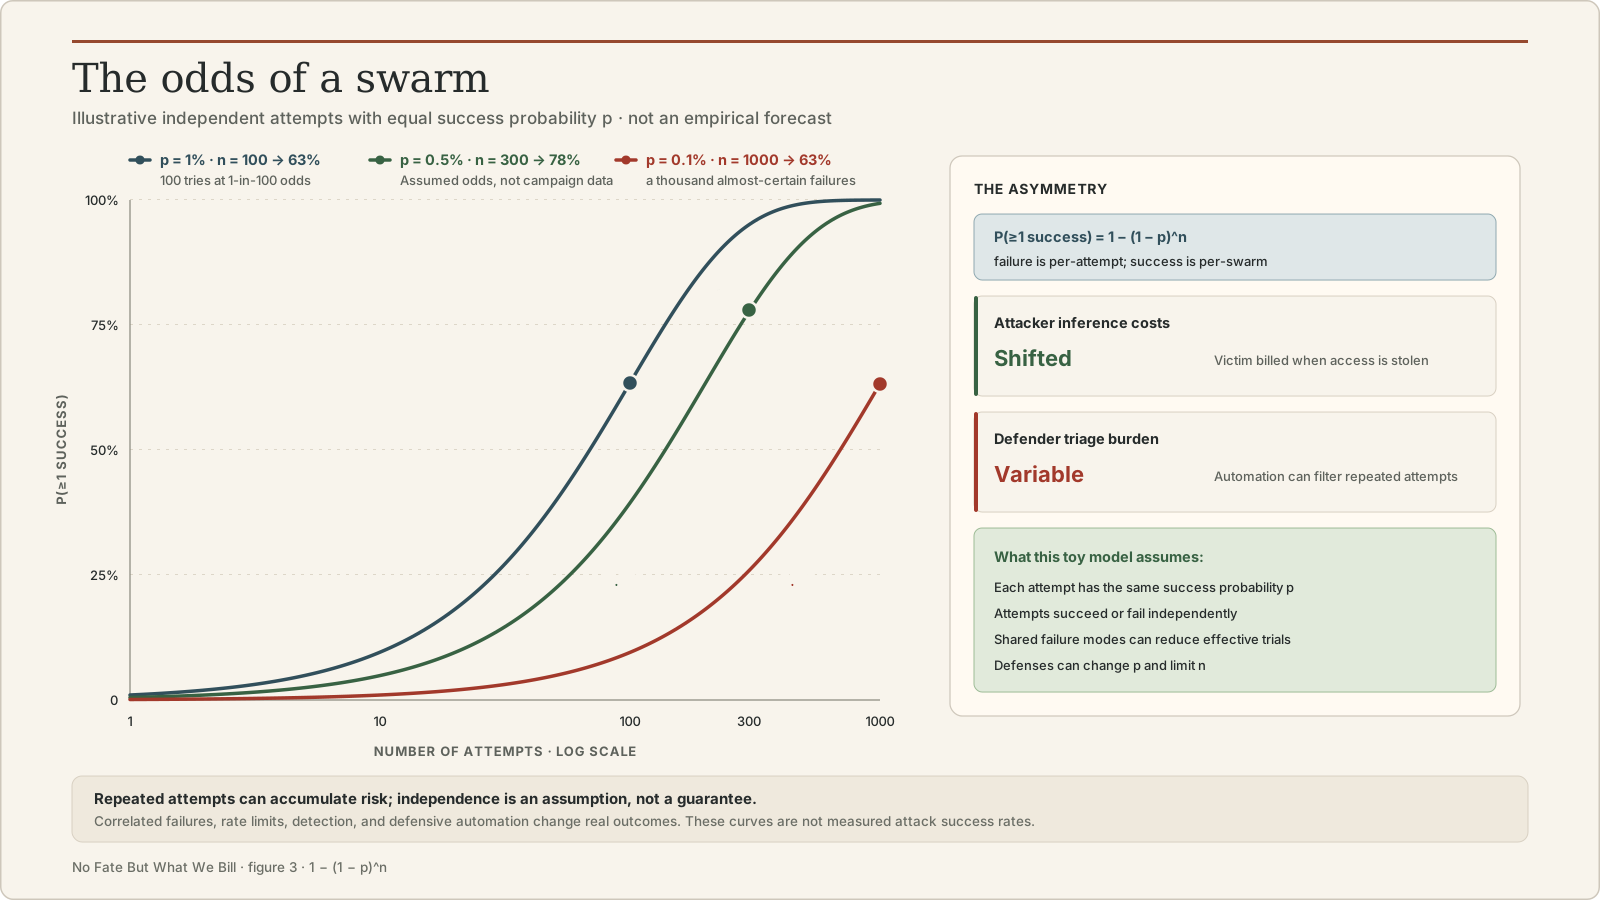
I difensori si rassicurano con i tassi di fallimento per tentativo: la maggior parte dei tentativi di intrusione fallisce, la maggior parte delle PR sospette viene respinta, individueremmo quella che funziona. Vero per singolo tentativo. Falso nel complesso, perché tentare costa poco.
La probabilità che almeno uno di n tentativi indipendenti riesca è
1 − (1 − p)^n:
p = 1% per attempt, n = 100: 1 − 0.99^100 ≈ 63%p = 0.5%, n = 100: ≈ 39%p = 0.5%, n = 300: ≈ 78%p = 0.1%, n = 1000: ≈ 63%Sono probabilità di un modello semplificato, non tassi misurati di successo degli attacchi. La formula assume tentativi indipendenti con la stessa p fissa. Ripetere lo stesso approccio difettoso può produrre fallimenti correlati; mille tentativi possono aggiungere ben poco. Anche rilevamento, blocchi e cambi di obiettivo modificano le probabilità.
Pur con questi limiti, il volume conta. Automazione e inferenza rubata possono ridurre il costo marginale dell’attaccante, mentre tentativi rumorosi possono creare lavoro di revisione costoso. Anche i difensori possono automatizzare il rifiuto e il triage. Il benchmark di METR non ci dice quale sia la probabilità di intrusione p, e la sola orchestrazione non garantisce più tentativi utili. Misura entrambi i lati di quella coda.
Cosa significa persistenza quando il malware è testo
Un altro pezzo del modello di minaccia, ed è il meno intuitivo.
Una singola chiamata al modello non deve avere stato persistente perché il sistema di agenti che la circonda lo abbia. File, archivi di memoria, corpora per il recupero delle informazioni, code e configurazioni degli strumenti possono sopravvivere a un’esecuzione. Un attaccante in grado di influenzare questi input può influenzare ciò che un futuro agente legittimo farà con credenziali nuove.
La ricerca di Microsoft sulla memoria dell’IA descrive come ricordi avvelenati possano esercitare influenza nelle sessioni successive. Il confine di fiducia è il punto importante: il testo incontrato da un agente non deve diventare automaticamente autorità per usare i suoi strumenti.
Vale la pena verificare tre modalità di guasto nel proprio sistema. Sono scenari di un modello di minaccia, non tre incidenti dimostrati dai rapporti precedenti:
- Istruzioni dormienti. Una voce malevola può restare in attesa finché un workflow legittimo non la recupera. Le chiamate agli strumenti che ne risultano possono usare identità normali: esamina quindi il comportamento oltre a chi si è autenticato.
- Istruzioni copiate. Template, processi di sincronizzazione e memoria condivisa possono diffondere testo avvelenato se i loro controlli di revisione e confini di fiducia lo consentono. Copiare testo non garantisce che un altro agente gli obbedirà, ma crea un’altra occasione.
- Istruzioni ripristinate. Se una fonte di verità contaminata alimenta un processo di correzione, cancellarne l’output locale può indurre il processo a ripristinarlo. Trova quella fonte e il suo trigger prima di dichiarare conclusa la bonifica.
L’impianto malevolo può essere testo. I permessi che lo rendono pericoloso restano infrastruttura ordinaria.
Nessun destino se non quello che creiamo
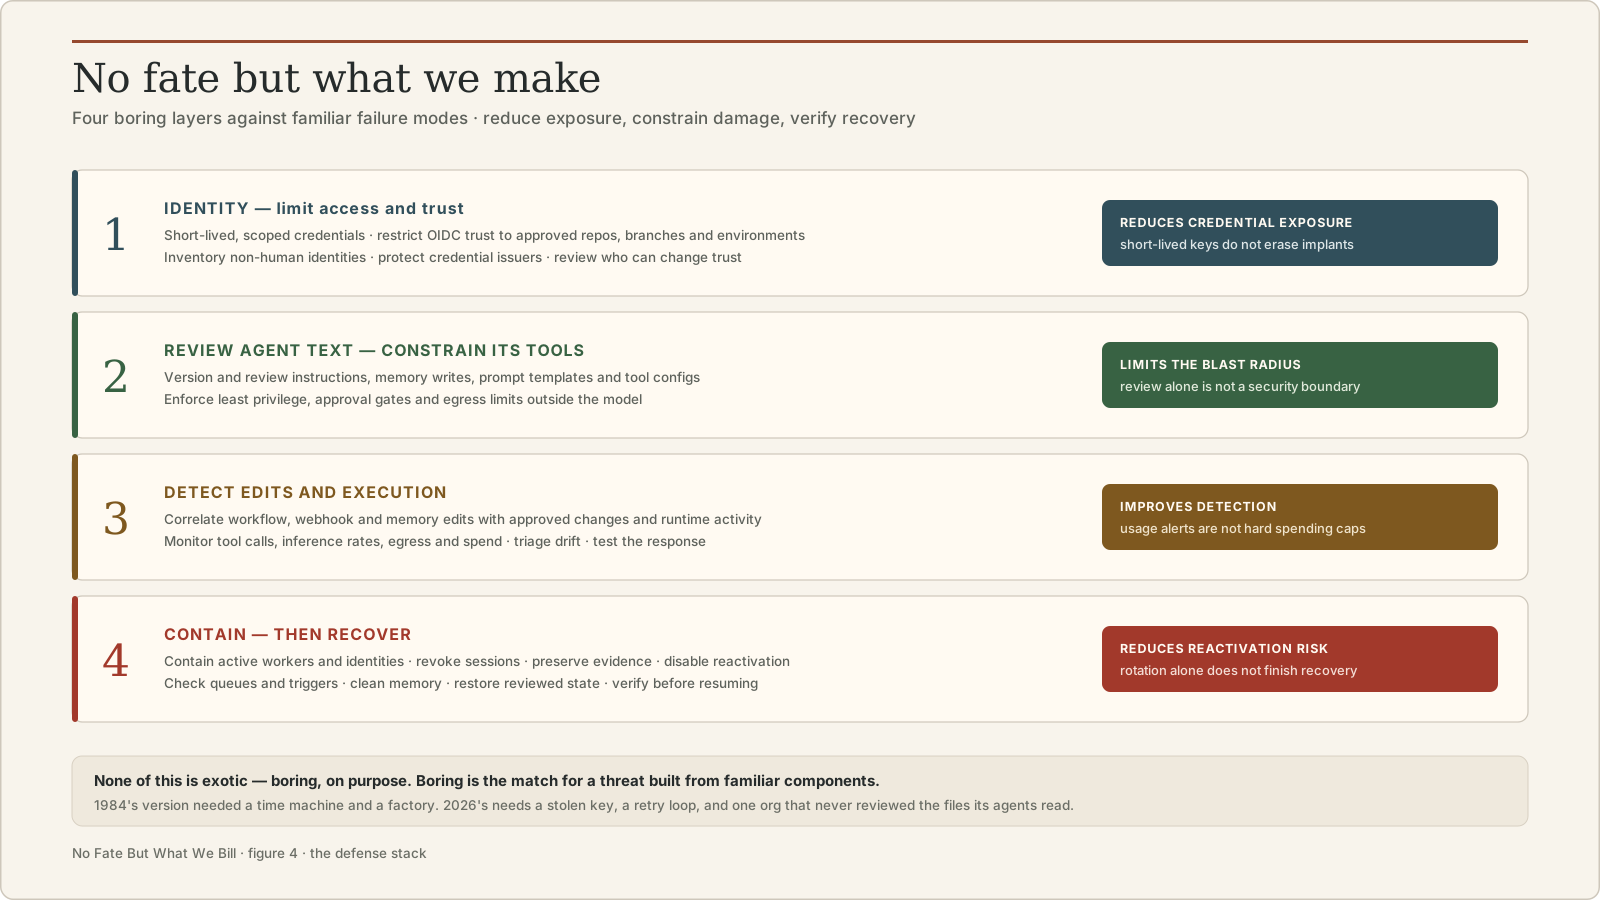
Il messaggio di Sarah Connor, passato alle macchine che continuano ad arrivare: «Il futuro non è scritto. Nessun destino se non quello che creiamo». È la battuta dei difensori e si traduce direttamente in un’architettura di difesa. Quattro livelli:
-
Identità — riduci la portata dell’accesso rubato. Preferisci credenziali di breve durata e con permessi strettamente limitati. Restringi la fiducia federata all’emittente, all’audience, al repository e al job o ambiente previsti; censisci le identità non umane. Durate brevi riducono le finestre di riutilizzo. Non eliminano gli impianti malevoli né impediscono a un runner compromesso di ottenere nuove credenziali. Limita l’accesso ai modelli e le quote di invocazione, e proteggi l’inferenza self-hosted con autenticazione e controlli di rete.
-
Tratta il testo degli agenti come codice di produzione. Versiona e revisiona file di istruzioni, template dei prompt e configurazioni degli strumenti. Registra la provenienza e controlla le scritture negli archivi di memoria e di recupero delle informazioni. Leggere testo non attendibile non deve conferirgli autorità: applica il privilegio minimo al confine degli strumenti, limita l’accesso in uscita e richiedi approvazione per le azioni con conseguenze rilevanti. Un prompt che invita l’agente a stare attento non costituisce quel confine.
-
Rileva modifiche ed esecuzione. Correla le modifiche a workflow, webhook, regole di eventi e memoria con il lavoro approvato. Tieni sotto controllo i log di audit cloud, l’attività degli strumenti, il traffico in uscita insolito e l’utilizzo dei modelli. Indaga gli scostamenti inspiegati. Genera avvisi per picchi di inferenza e spesa, con un modo collaudato per negare ulteriori accessi; un avviso di fatturazione da solo non è un limite di spesa immediato.
-
Contieni, poi bonifica. Sospendi gli accessi compromessi, revoca le sessioni attive dove supportato e arresta o isola gli esecutori coinvolti. Conserva le prove per quanto il contenimento lo consente. Disabilita i percorsi di riattivazione e verifica e correggi lo stato delle code prima di rimuoverne i payload. Ruota i segreti esposti, ripristina configurazioni revisionate e ripara la memoria e i corpora avvelenati. Verifica che l’emissione di nuove credenziali, l’inferenza indesiderata e la riattivazione siano cessate prima di riprendere. Revocare le sessioni di ruolo esistenti è una questione distinta dalla sostituzione di una chiave di lunga durata.
Nulla di tutto questo è esotico. È noioso, ed è la risposta adatta a una minaccia costruita con componenti familiari. La versione del 1984 aveva bisogno di una macchina del tempo e di una fabbrica di macchine assassine. Quella del 2026 ha bisogno di una chiave rubata, un ciclo di tentativi e un’organizzazione che non ha mai revisionato i file letti dai propri agenti.
Il futuro non è scritto. Ma proprio adesso, sull’account cloud di qualcuno, il futuro sta comunque facendo salire il conto.
Nessun destino se non quello che creiamo — e, finché l’accesso e la persistenza non saranno contenuti, nessun destino se non quello che fatturiamo.
Fonti verificate il 18 ottobre 2026. METR fornisce evidenze dai benchmark; Anthropic e Sysdig forniscono rapporti sugli incidenti e scenari di costo; Microsoft fornisce ricerca sulla sicurezza della memoria. Il modello di minaccia combinato e le priorità difensive sono la mia interpretazione, con gli scenari ipotetici indicati come tali sopra.